Guía de la API de GLM 5.3: Precios, ID del modelo y tu primera solicitud en SiliconFlow
Índice de contenidos
Puede acceder a GLM-5.3 en SiliconFlow a través de la API de Chat Completions compatible con OpenAI. Use el ID de modelo zai-org/GLM-5.3, envíe solicitudes a https://api.siliconflow.com/v1/chat/completions y autentíquese con una API Key de SiliconFlow.
A partir del 9 de septiembre de 2026, GLM-5.3 cuesta $1.40 por millón de tokens de entrada (input), $0.26 por millón de tokens de entrada (input) almacenados en caché y $4.40 por millón de tokens de salida (output) en SiliconFlow.
Qué necesita para acceder a la API de GLM 5.3
Prepare lo siguiente antes de enviar su primera solicitud:
Elemento | Valor o requisito |
|---|---|
Cuenta de SiliconFlow | Requerida para crear y gestionar API Keys |
API Key | Generada desde la consola de SiliconFlow |
Endpoint de la API | https://api.siliconflow.com/v1/chat/completions |
ID de modelo de la API de GLM 5.3 | zai-org/GLM-5.3 |
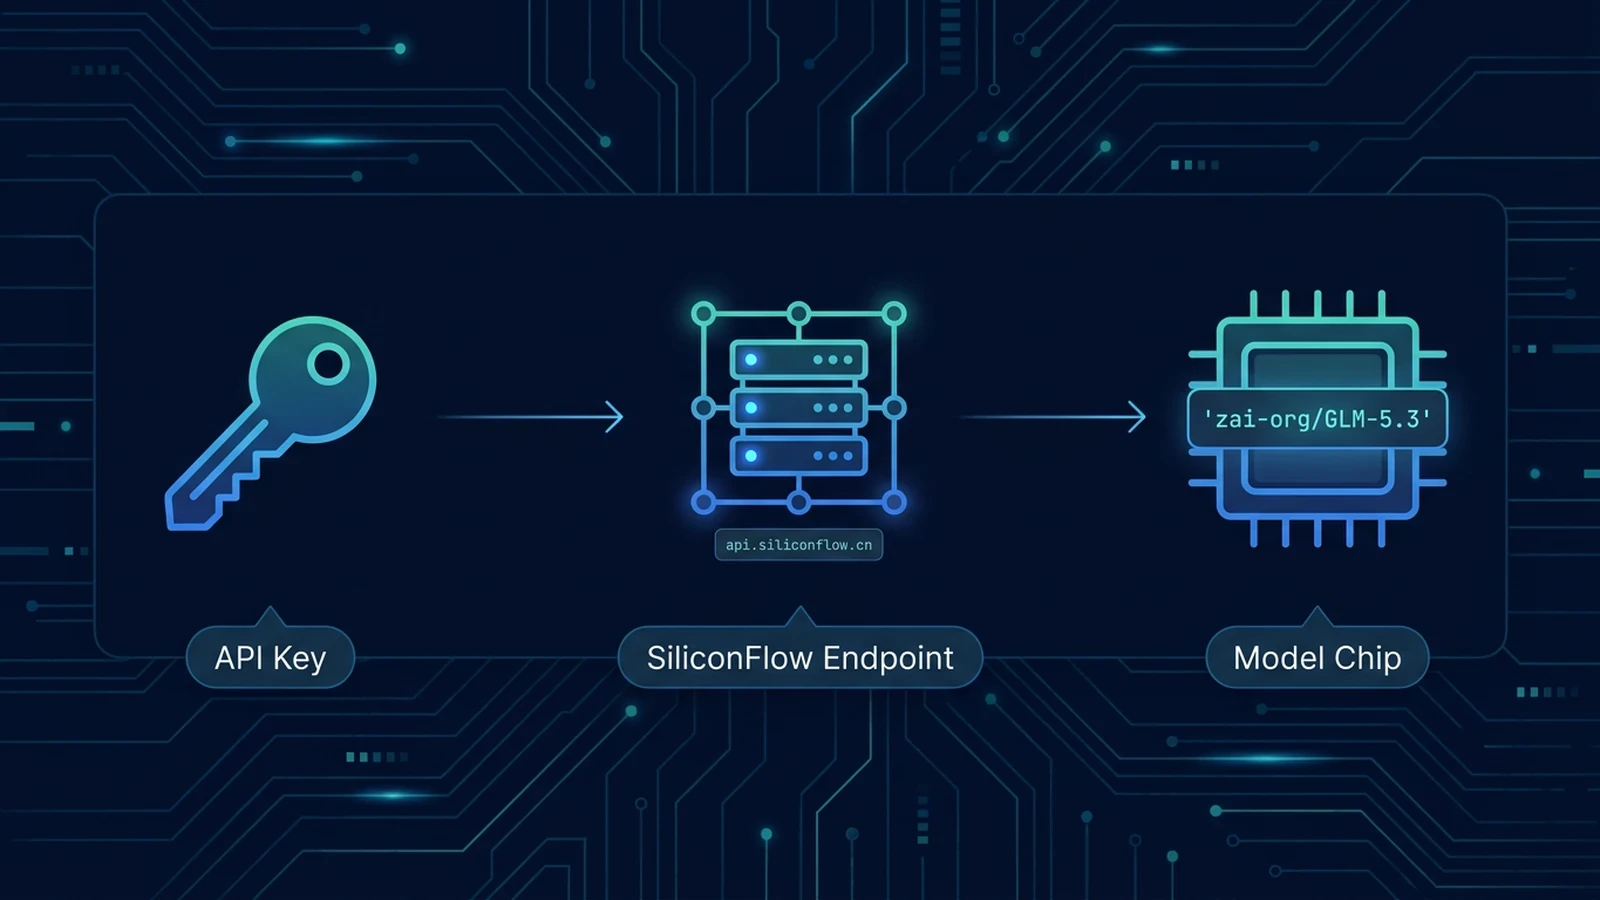
Cree una clave desde la página de API Keys de SiliconFlow. Cópiela cuando se genere y guárdela fuera de su código fuente. Los siguientes ejemplos leen la clave de una variable de entorno llamada SILICONFLOW_API_KEY.
En macOS o Linux, establezca la variable con:
En Windows PowerShell, use:
Instale el paquete requests de Python si aún no está disponible:
El espacio de nombres es una parte importante del ID de modelo. Los valores como glm-5.3, GLM-5.3 o zai/GLM-5.3 no identifican el despliegue de SiliconFlow. Copie zai-org/GLM-5.3 exactamente de la página del modelo GLM-5.3.
Envíe su primera solicitud a GLM 5.3 con Python
El siguiente ejemplo en Python para GLM 5.3 envía una solicitud de Chat Completions sin transmisión (non-streaming). Incluye validación de variables de entorno, un tiempo de espera (timeout) del cliente y un informe básico de errores HTTP.
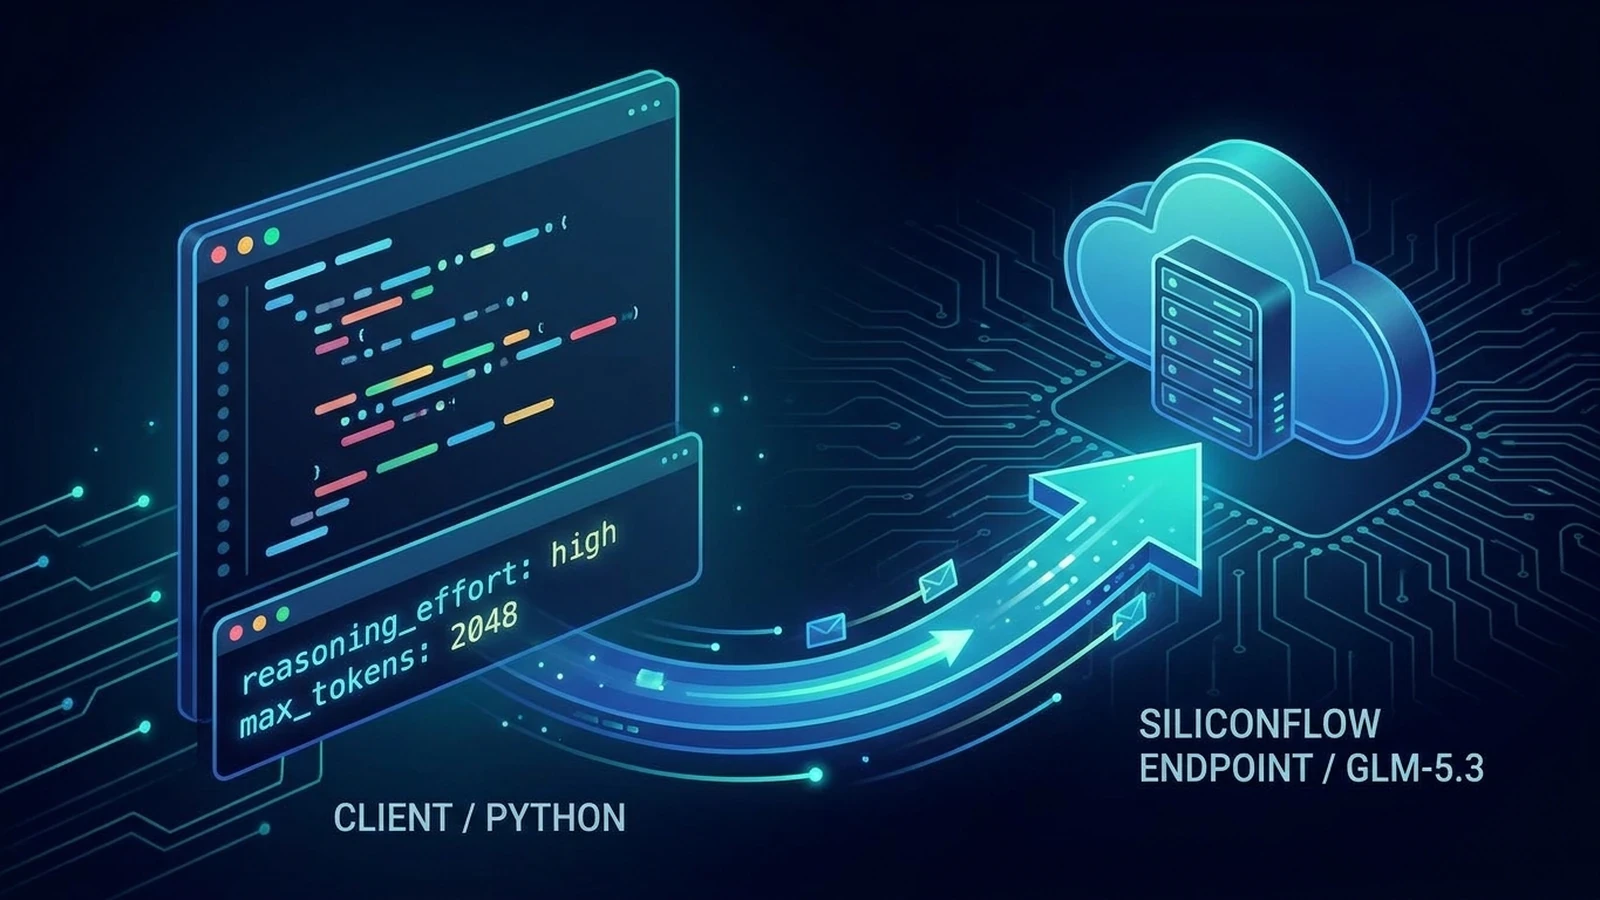
GLM-5.3 siempre utiliza razonamiento activo, con tres configuraciones para controlar el esfuerzo de razonamiento:
Valor | Punto de partida práctico |
|---|---|
low | Transformaciones de rutina y tareas de código sencillas |
high | Depuración, generación de código y razonamiento moderadamente complejo |
max | Análisis de múltiples archivos, trabajo de arquitectura y tareas de agentes de larga ejecución |
high es un punto de partida práctico cuando se prueba la API. Cambie a max cuando las tareas representativas demuestren que el razonamiento adicional mejora el resultado lo suficiente como para justificar respuestas potencialmente más largas y un uso total de tokens más alto.
El campo max_tokens limita cuántos tokens puede generar el modelo. No reserva ni cobra por ese número por adelantado. La facturación se basa en los tokens procesados y generados.
Lea la respuesta y habilite la transmisión (Streaming)
Una respuesta exitosa sin transmisión sigue la estructura de Chat Completions de la referencia de la API de SiliconFlow. Los campos que la mayoría de las aplicaciones necesitan son:
content contiene la respuesta final destinada al usuario. Las respuestas de modelos de razonamiento también pueden incluir reasoning_content como un campo separado. Las aplicaciones normalmente deberían mostrar o almacenar el contenido final en lugar de combinar ambos campos en la respuesta orientada al usuario.
Verifique finish_reason antes de tratar una respuesta como completa. Registre también el objeto de uso (usage) durante las pruebas de prompts, ya que la longitud de la salida (output) puede tener un efecto significativo en el costo total de la solicitud.
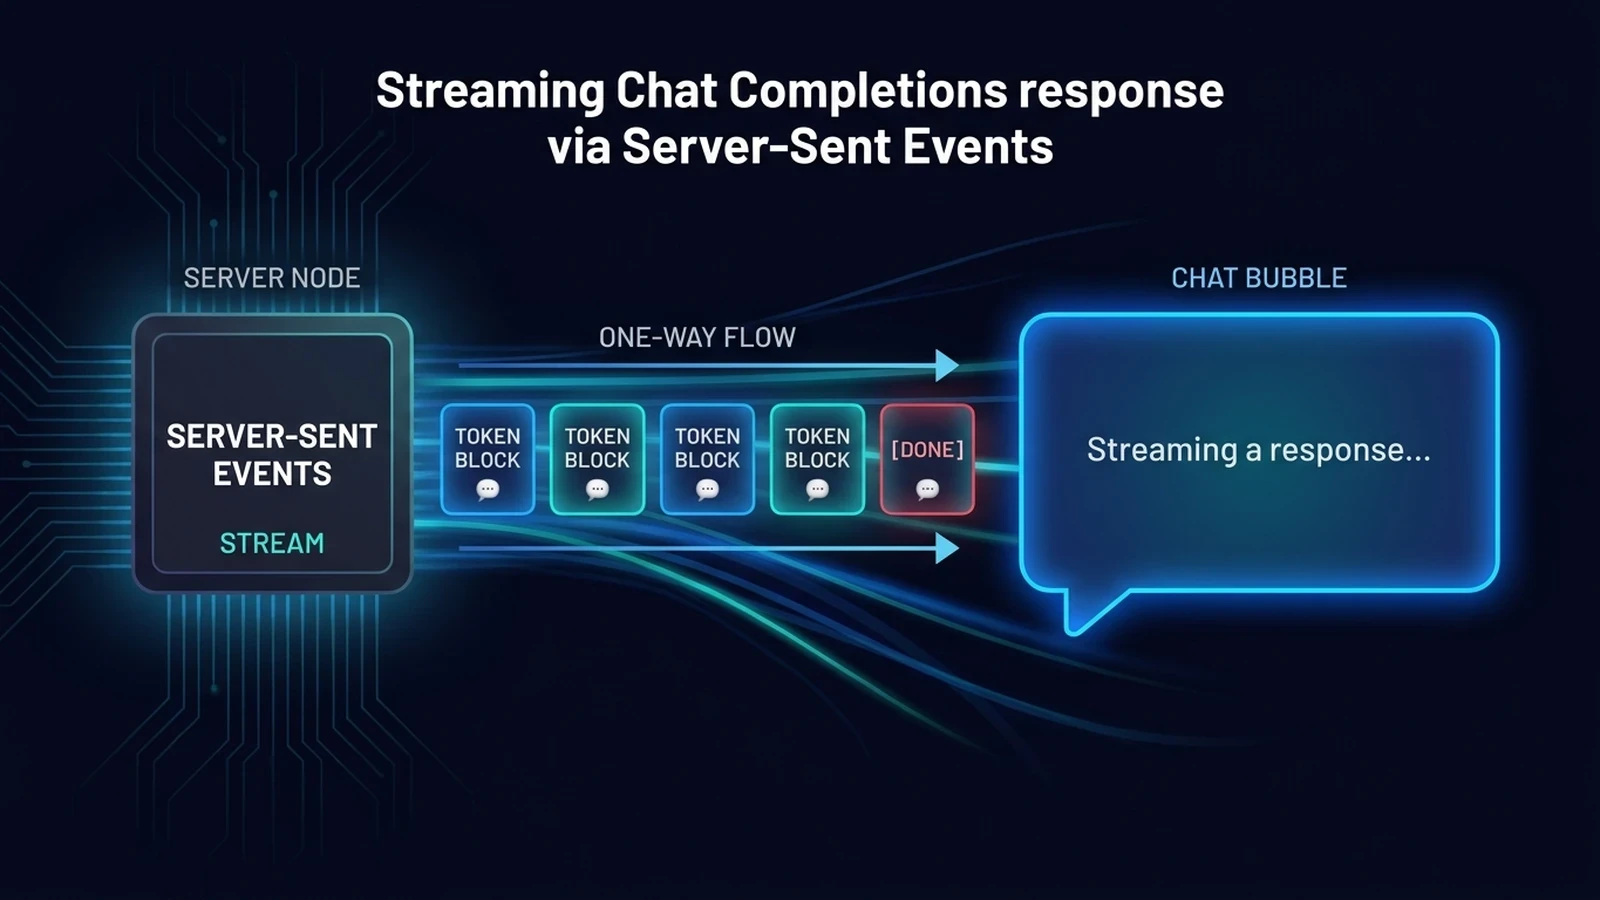
Para chat interactivo, asistentes de código y respuestas más largas, establezca stream en True. SiliconFlow devuelve Server-Sent Events y finaliza la transmisión con data: [DONE].
Este analizador ignora los eventos vacíos y los eventos que no contienen un token de contenido. Un cliente de producción también debería capturar las interrupciones de conexión y determinar si volver a intentar la solicitud podría repetir un trabajo que el modelo ya ha completado.
Precios de la API de GLM 5.3 y ejemplos de costos
Los precios actuales de SiliconFlow utilizan tarifas separadas para entrada (input) no almacenada en caché, entrada (input) almacenada en caché y salida (output):
Tipo de uso | Precio por millón de tokens |
|---|---|
Input | $1.40 |
Input almacenado en caché | $0.26 |
Output | $4.40 |
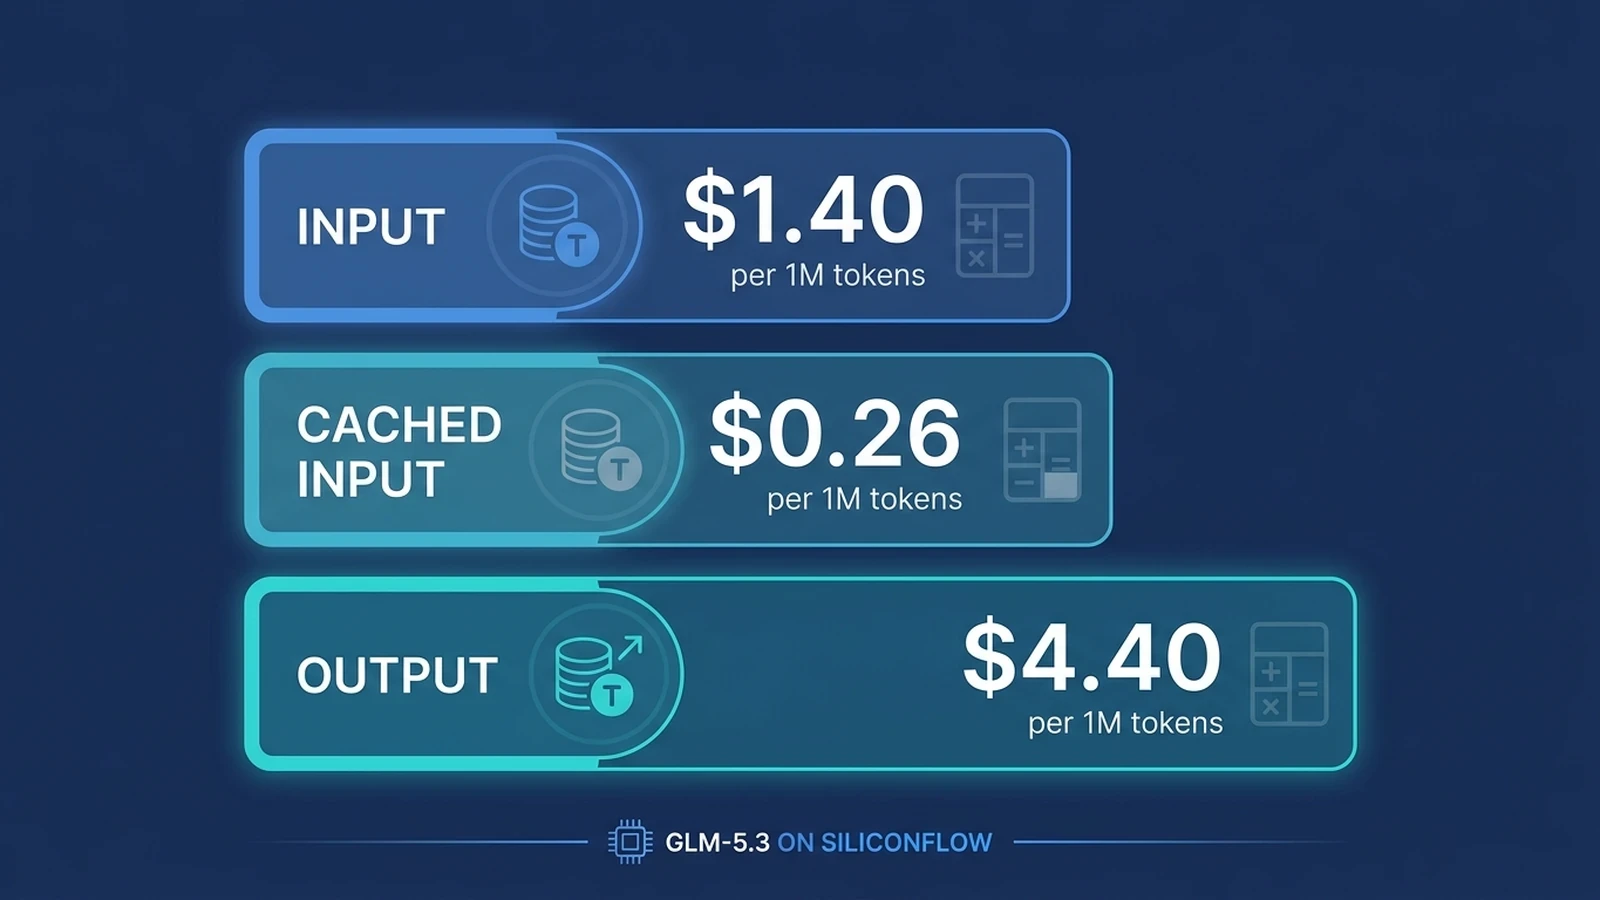
Estos precios se aplican al despliegue zai-org/GLM-5.3 de SiliconFlow a partir del 9 de septiembre de 2026. Los precios de la API directa de Z.AI u otro proveedor de inferencia no deben utilizarse para estimar el costo de las solicitudes enviadas a través de SiliconFlow.
Calcule el costo estimado con:
Costo estimado (USD) = (tokens de input no almacenados en caché / 1,000,000 * 1.40) + (tokens de input almacenados en caché / 1,000,000 * 0.26) + (tokens de output / 1,000,000 * 4.40) Divida el número de tokens en cada categoría por un millón, multiplique cada resultado por su precio aplicable y luego sume los tres montos.
Los siguientes ejemplos son hipotéticos:
Carga de trabajo | Uso de tokens | Costo estimado |
|---|---|---|
1,000 solicitudes cortas | 1M de input + 200K de output | $1.40 + $0.88 = $2.28 |
100 solicitudes de análisis de código | 5M de input + 500K de output | $7.00 + $2.20 = $9.20 |
1,000 solicitudes con contexto repetido | 2M de input no almacenado en caché + 8M de input almacenado en caché + 2M de output | $2.80 + $2.08 + $8.80 = $13.68 |
El tercer ejemplo asume que 8 millones de tokens de entrada (input) califican para el precio de entrada almacenada en caché. Trátelo como una estimación, ya que el costo real facturado depende de las categorías de tokens aplicadas a cada solicitud.
El control de salida (output) merece especial atención con GLM-5.3. Con las tarifas estándar actuales, reducir un millón de tokens de entrada (input) ahorra $1.40, mientras que reducir un millón de tokens de salida (output) ahorra $4.40. Establezca un valor de max_tokens realista y proporcione al modelo un formato de salida claro en lugar de permitir que cada solicitud produzca una respuesta innecesariamente larga.
El costo por solicitud también es diferente del costo por tarea exitosa. Al evaluar GLM-5.3 para flujos de trabajo de código o agentes, realice un seguimiento de los reintentos, las salidas fallidas, el tiempo de corrección humana y el uso de tokens junto con el precio de la API indicado.
Solucionar errores de autenticación, ID de modelo y solicitudes
Comience a solucionar problemas con el estado HTTP, el cuerpo de la respuesta, el endpoint y el ID exacto del modelo. Los problemas de autenticación y formato de solicitud requieren una corrección en lugar de otra solicitud idéntica.
Error o síntoma | Causa probable | Qué comprobar |
|---|---|---|
Error: la variable SILICONFLOW_API_KEY local no está configurada | Falta la variable de entorno | Establezca la variable en la misma consola que ejecuta el script |
HTTP 401 o Token no válido | API Key faltante, no válida o mal formada | Confirme la clave y el formato Authorization: Bearer |
HTTP 400 con un objeto de error de API | Cuerpo de la solicitud, modelo o parámetro no válido | Comience con model y messages, luego agregue campos opcionales uno a uno |
Mensaje de modelo no encontrado o modelo no admitido | ID de modelo incorrecto | Use zai-org/GLM-5.3 respetando mayúsculas y puntuación |
HTTP 404 | URL o ruta incorrecta | Use https://api.siliconflow.com/v1/chat/completions |
HTTP 429 | Límite de solicitudes o tokens alcanzado a nivel de cuenta | Reduzca la concurrencia, aplique un retroceso (backoff) limitado y revise el límite de la cuenta |
HTTP 503 con código 50505 | El servicio del modelo está temporalmente sobrecargado | Reintente con retroceso exponencial y una variación aleatoria (jitter) |
HTTP 504 o tiempo de espera del cliente agotado | La solicitud tardó demasiado | Reintente con precaución, reduzca el tamaño del prompt o de la salida, o aumente el tiempo de espera del cliente |
Para una respuesta 429, 503 o 504, use una política de reintentos limitada, como tres intentos con retrasos incrementales. Agregue una variación aleatoria (jitter) cuando varios procesos de trabajo puedan reintentar al mismo tiempo. No reintente automáticamente las respuestas 400 o 401 sin corregir primero la solicitud o las credenciales.
Si una solicitud funciona sin reasoning_effort pero falla después de agregar ese campo, verifique el ID del modelo y el valor del parámetro. GLM-5.3 admite low, high y max; es posible que los parámetros copiados de otro modelo o proveedor no sean aceptados por el despliegue de SiliconFlow.
Una secuencia de validación útil es probar el prompt a través de la página del modelo GLM-5.3 y luego enviar una solicitud de API mínima que contenga solo el model y messages. Una vez que funcione, agregue los controles de razonamiento, los límites de salida, la transmisión (streaming) y las herramientas de manera individual.
Preguntas comunes sobre la API de GLM 5.3
P1. ¿Puedo usar el SDK de Python de OpenAI con la API de GLM 5.3?
Sí. Establezca la URL base del SDK en https://api.siliconflow.com/v1, proporcione su API Key de SiliconFlow y use zai-org/GLM-5.3 como modelo. Verifique que se admitan todos los parámetros opcionales antes de copiarlos de otro proveedor.
P2. ¿Puede GLM-5.3 aceptar imágenes a través de SiliconFlow?
No. El despliegue de GLM-5.3 en SiliconFlow acepta entradas de texto (text) y devuelve salidas de texto (text). Elija un modelo con soporte documentado de entrada de imágenes (image) cuando su aplicación necesite analizar capturas de pantalla, diagramas, fotografías u otro contenido visual.
P3. ¿Admite GLM-5.3 la llamada a funciones (Tool Calling) en SiliconFlow?
Sí. El despliegue de SiliconFlow admite herramientas de función a través de la API de Chat Completions. Defina las funciones disponibles en el arreglo de herramientas (tools) y maneje las llamadas tool_calls devueltas en su aplicación antes de enviar el resultado de la herramienta de vuelta al modelo.
P4. ¿Son GLM-5.3 y GLM-5.3-Flash el mismo modelo de API?
No. Son despliegues separados de SiliconFlow con diferentes ID de modelo, capacidades y precios. Use zai-org/GLM-5.3 para el modelo tratado aquí y verifique la página del modelo GLM-5.3-Flash antes de cambiar una aplicación a esa variante.