Índice de contenidos
Sí. GLM-5.3 es muy adecuado para la programación compleja y la ingeniería de software impulsada por agentes. Sus casos de uso más sólidos incluyen la depuración a nivel de repositorio, operaciones de terminal, refactorización de múltiples archivos y tareas de larga duración que requieren llamadas repetidas a herramientas.
GLM-5.3 ya está disponible en SiliconFlow, donde los desarrolladores pueden probarlo en el Playground antes de conectarlo a herramientas de programación, agentes o entornos de evaluación existentes a través de una API compatible con OpenAI.
Su idoneidad es más limitada para el desarrollo visual, el autocompletado instantáneo y otras cargas de trabajo sensibles a la latencia. GLM-5.3 solo acepta Text, mantiene el razonamiento habilitado en cada solicitud y aún dispone de datos de evaluación independientes limitados por ser reciente. Su ventana de contexto de un millón de tokens es valiosa, pero no garantiza una comprensión precisa de cada archivo colocado en el prompt.
Este análisis refleja la información disponible públicamente y la disponibilidad del modelo verificada a fecha de 22 de agosto de 2026.
¿Para qué está diseñado GLM-5.3?
GLM-5.3 es el modelo de Text insignia de Z.ai para ingeniería de software compleja y tareas de agente de largo alcance. Utiliza el mismo modelo base que GLM-5.2; las mejoras reportadas provienen de un postentrenamiento adicional en lugar de una nueva arquitectura de base.
Esa distinción es importante. La mejora principal no es simplemente un conocimiento más amplio o un mayor número de parámetros. Z.ai entrenó a GLM-5.3 en entornos más ejecutables y verificables que se asemejan al trabajo de ingeniería real. Estos entornos requieren que el modelo inspeccione sistemas, modifique código, ejecute herramientas, evalúe resultados y continúe trabajando tras un intento fallido.
Por lo tanto, el modelo se enfoca en trabajos tales como:
Diagnosticar problemas en múltiples archivos
Implementar y probar cambios a nivel de repositorio
Operar en entornos de desarrollo basados en terminal
Coordinar varias herramientas a lo largo de muchos pasos
Mantener el estado de la tarea durante sesiones largas de agentes
Analizar código fuente en busca de debilidades de seguridad
Según la documentación oficial de GLM-5.3, el modelo admite la llamada a funciones, respuestas en streaming, argumentos de llamada a herramientas en streaming, almacenamiento en caché de contexto y Output estructurado. Estas capacidades lo hacen más relevante para agentes de programación que para la simple completación de código básica.
Los desarrolladores pueden verificar estas capacidades con su propia carga de trabajo en el Playground de SiliconFlow. Comience con una tarea representativa del repositorio, defina el resultado esperado y las pruebas, y compare el Output del modelo con su flujo de trabajo de programación actual antes de ampliar la evaluación.
¿Qué tareas de programación y de agentes se benefician más de GLM-5.3?
El rendimiento de programación de GLM-5.3 debe evaluarse por tipo de tarea. Un modelo que funciona bien en un agente de terminal puede no ser la opción más rápida o económica para generar una función de cinco líneas.
Tarea | Ajuste esperado | Por qué |
|---|---|---|
Depuración de múltiples archivos | Sólido | El modelo puede combinar código, registros, pruebas y configuración dentro de un mismo contexto de trabajo. |
Refactorización de repositorios | Sólido | El contexto largo y el entrenamiento de agentes admiten cambios que abarcan módulos y dependencias. |
Automatización de terminales | Sólido | Los resultados públicos muestran grandes mejoras en tareas ejecutables de línea de comandos. |
Generación y reparación de pruebas | Sólido | El modelo puede generar pruebas, ejecutarlas a través de un agente y corregir los cambios fallidos. |
Trabajo de backend e infraestructura | Sólido | Estas tareas se benefician de la planificación, el uso de herramientas, los registros y la verificación repetida. |
Revisión defensiva de código | Prometedor | GLM-5.3 reporta sólidos resultados en la detección de vulnerabilidades, aunque la validación por parte de expertos sigue siendo necesaria. |
Autocompletado en línea | Mixto | El razonamiento siempre activo puede añadir una latencia innecesaria a completaciones cortas y predecibles. |
De captura de pantalla a código | Deficiente | GLM-5.3 solo acepta Text y no puede inspeccionar capturas de pantalla ni archivos de diseño directamente. |
La ventaja práctica aparece cuando se permite al modelo completar un ciclo de ingeniería:
Inspeccionar el repositorio y la tarea.
Formular un plan.
Editar los archivos pertinentes.
Ejecutar pruebas o comandos de terminal.
Interpretar los fallos.
Corregir la implementación.
Reportar los cambios finales y los riesgos no resueltos.
Para explicaciones sencillas de código, generación de código repetitivo o conversión de sintaxis, un modelo más pequeño y rápido puede proporcionar una mejor relación coste-latencia.
¿Cómo afectan el espacio de contexto de 1M y los niveles de razonamiento al trabajo de programación?
GLM-5.3 admite una ventana de contexto de un millón de tokens y hasta 128K tokens de Output a través de la API de Z.ai. Esto permite que un agente retenga sustancialmente más código fuente, documentación, Output de herramientas e historial de conversación que un asistente de programación convencional.
Sin embargo, la capacidad de contexto es un límite máximo, no una promesa de comprensión perfecta del repositorio. Llenar la solicitud con cada archivo puede aumentar la latencia, el coste y las distracciones. Siguen siendo útiles la recuperación relevante, los mapas de repositorios, la información de dependencias y la selección selectiva de archivos.
La ventana más grande es más valiosa cuando la tarea depende realmente de información distante; por ejemplo, cuando un cambio en la API afecta al código de la aplicación, las pruebas, las definiciones de infraestructura y la documentación interna.
GLM-5.3 siempre funciona con el razonamiento habilitado. Intentar desactivarlo produce un error. En su lugar, los desarrolladores pueden seleccionar uno de los tres niveles de esfuerzo de razonamiento:
Nivel de razonamiento | Mejor uso para |
|---|---|
bajo | Explicación de código, ediciones pequeñas, formateo y transformaciones sencillas |
alto | Depuración moderada, generación de pruebas e implementación en múltiples archivos |
máximo | Decisiones de arquitectura, defectos difíciles, refactorización de repositorios y ejecuciones largas de agentes |
El nivel máximo es el predeterminado y la recomendación de Z.ai para programación compleja. No debería usarse automáticamente para cada solicitud. Los equipos deben comparar la calidad de la completación frente a la latencia y el consumo de tokens, especialmente para herramientas de desarrollo de gran volumen.
Al migrar desde un modelo anterior, revise los requisitos de migración de GLM-5.3. Las aplicaciones que envían thinking.type: "disabled" deben actualizarse antes de cambiar los ID de modelo.
¿Qué muestran realmente las pruebas de rendimiento actuales de GLM-5.3?
Los resultados disponibles muestran una mejora sustancial con respecto a GLM-5.2 en la programación basada en agentes. No demuestran que GLM-5.3 vaya a superar a todos los modelos de la competencia en cada lenguaje, framework o repositorio.
Z.ai reporta los siguientes resultados:
Prueba de rendimiento | GLM-5.2 | GLM-5.3 | Qué evalúa |
|---|---|---|---|
Terminal-Bench 3.0 | 4.6 | 28.3 | Tareas ejecutables en entornos de terminal |
DeepSWE v1.1 | 46.2 | 66.9 | Rendimiento de agentes de ingeniería de software |
Agents’ Last Exam (CLI) | 23.8 | 28.5 | Tareas más amplias de agentes de línea de comandos |
Z.ai Code Bench, Max | 23.4% | 34.5% | Escenarios privados y realistas de agentes de programación |
En Z.ai Code Bench, GLM-5.3 alcanzó un 34.5% utilizando aproximadamente 75K tokens de Output por tarea. GLM-5.2 alcanzó un 23.4% utilizando alrededor de 96K. El resultado sugiere que el modelo más nuevo completó más tareas generando menos tokens de Output.
El frecuentemente citado “rendimiento de programación un 50% mejor” es una mejora relativa, no un aumento de 50 puntos porcentuales. Pasar del 23.4% al 34.5% representa aproximadamente una ganancia relativa del 47%.
Estas cifras aún requieren una interpretación cuidadosa:
La mayoría son resultados del desarrollador del modelo.
Z.ai Code Bench es privado y no se puede reproducir de forma independiente.
Los entornos de agentes, los permisos de herramientas, los límites de tiempo y los presupuestos de razonamiento afectan a las puntuaciones.
Los resultados de Terminal-Bench 3.0 no deben compararse directamente con los de Terminal-Bench 2.1.
Por ejemplo, Artificial Analysis evalúa Terminal-Bench 2.1 con el entorno Terminus 2, un sandbox E2B, 89 tareas verificadas y tres repeticiones. Esa metodología difiere de la de Terminal-Bench 3.0. Tratar sus puntuaciones como una única tabla de clasificación produciría una comparación engañosa.
La conclusión útil es más acotada: GLM-5.3 muestra un progreso claro en la programación ejecutable de largo alcance, pero los equipos aún necesitan realizar evaluaciones específicas para cada repositorio.
¿Qué límites deben verificar los desarrolladores antes de usar GLM-5.3?
GLM-5.3 tiene varios límites prácticos que deben probarse antes de su adopción en producción.
Primero, es solo de Text. No puede inspeccionar directamente capturas de pantalla de la interfaz de usuario, diagramas de arquitectura, vídeos o estados de error visuales. Un modelo Multimodal es una mejor opción cuando la tarea comienza con evidencia visual.
Segundo, el razonamiento no se puede desactivar. Incluso un esfuerzo bajo sigue utilizando razonamiento, lo que puede hacer que el modelo sea ineficiente para el autocompletado, la clasificación simple u otras solicitudes sensibles a la latencia.
Tercero, un contexto largo no elimina la necesidad de recuperar o gestionar el contexto. Los archivos duplicados, los recursos generados, los paquetes de dependencias y los registros obsoletos pueden consumir tokens sin mejorar el resultado.
Cuarto, unas puntuaciones sólidas en las pruebas de rendimiento no garantizan un funcionamiento autónomo seguro. Los agentes de programación pueden ejecutar comandos incorrectos, modificar archivos no relacionados, introducir dependencias vulnerables o pasar pruebas incompletas. Utilice límites de permisos, entornos aislados, control de versiones, comprobaciones automatizadas y revisión humana.
Por último, los límites de contexto a nivel de proveedor, los límites de Output, los parámetros admitidos, los ID de modelo y los precios pueden diferir de la API del desarrollador del modelo. Verifique la configuración de despliegue real en lugar de asumir que cada proveedor expone todas las capacidades nativas de GLM-5.3.
Cómo probar GLM-5.3 en SiliconFlow
GLM-5.3 ya está disponible en SiliconFlow. Comience abriendo la Biblioteca de Modelos de SiliconFlow y verifique el ID del modelo actual, los precios, los límites de contexto y Output, y los parámetros admitidos para el despliegue de SiliconFlow. Estos detalles pueden diferir de la API directa del desarrollador del modelo.
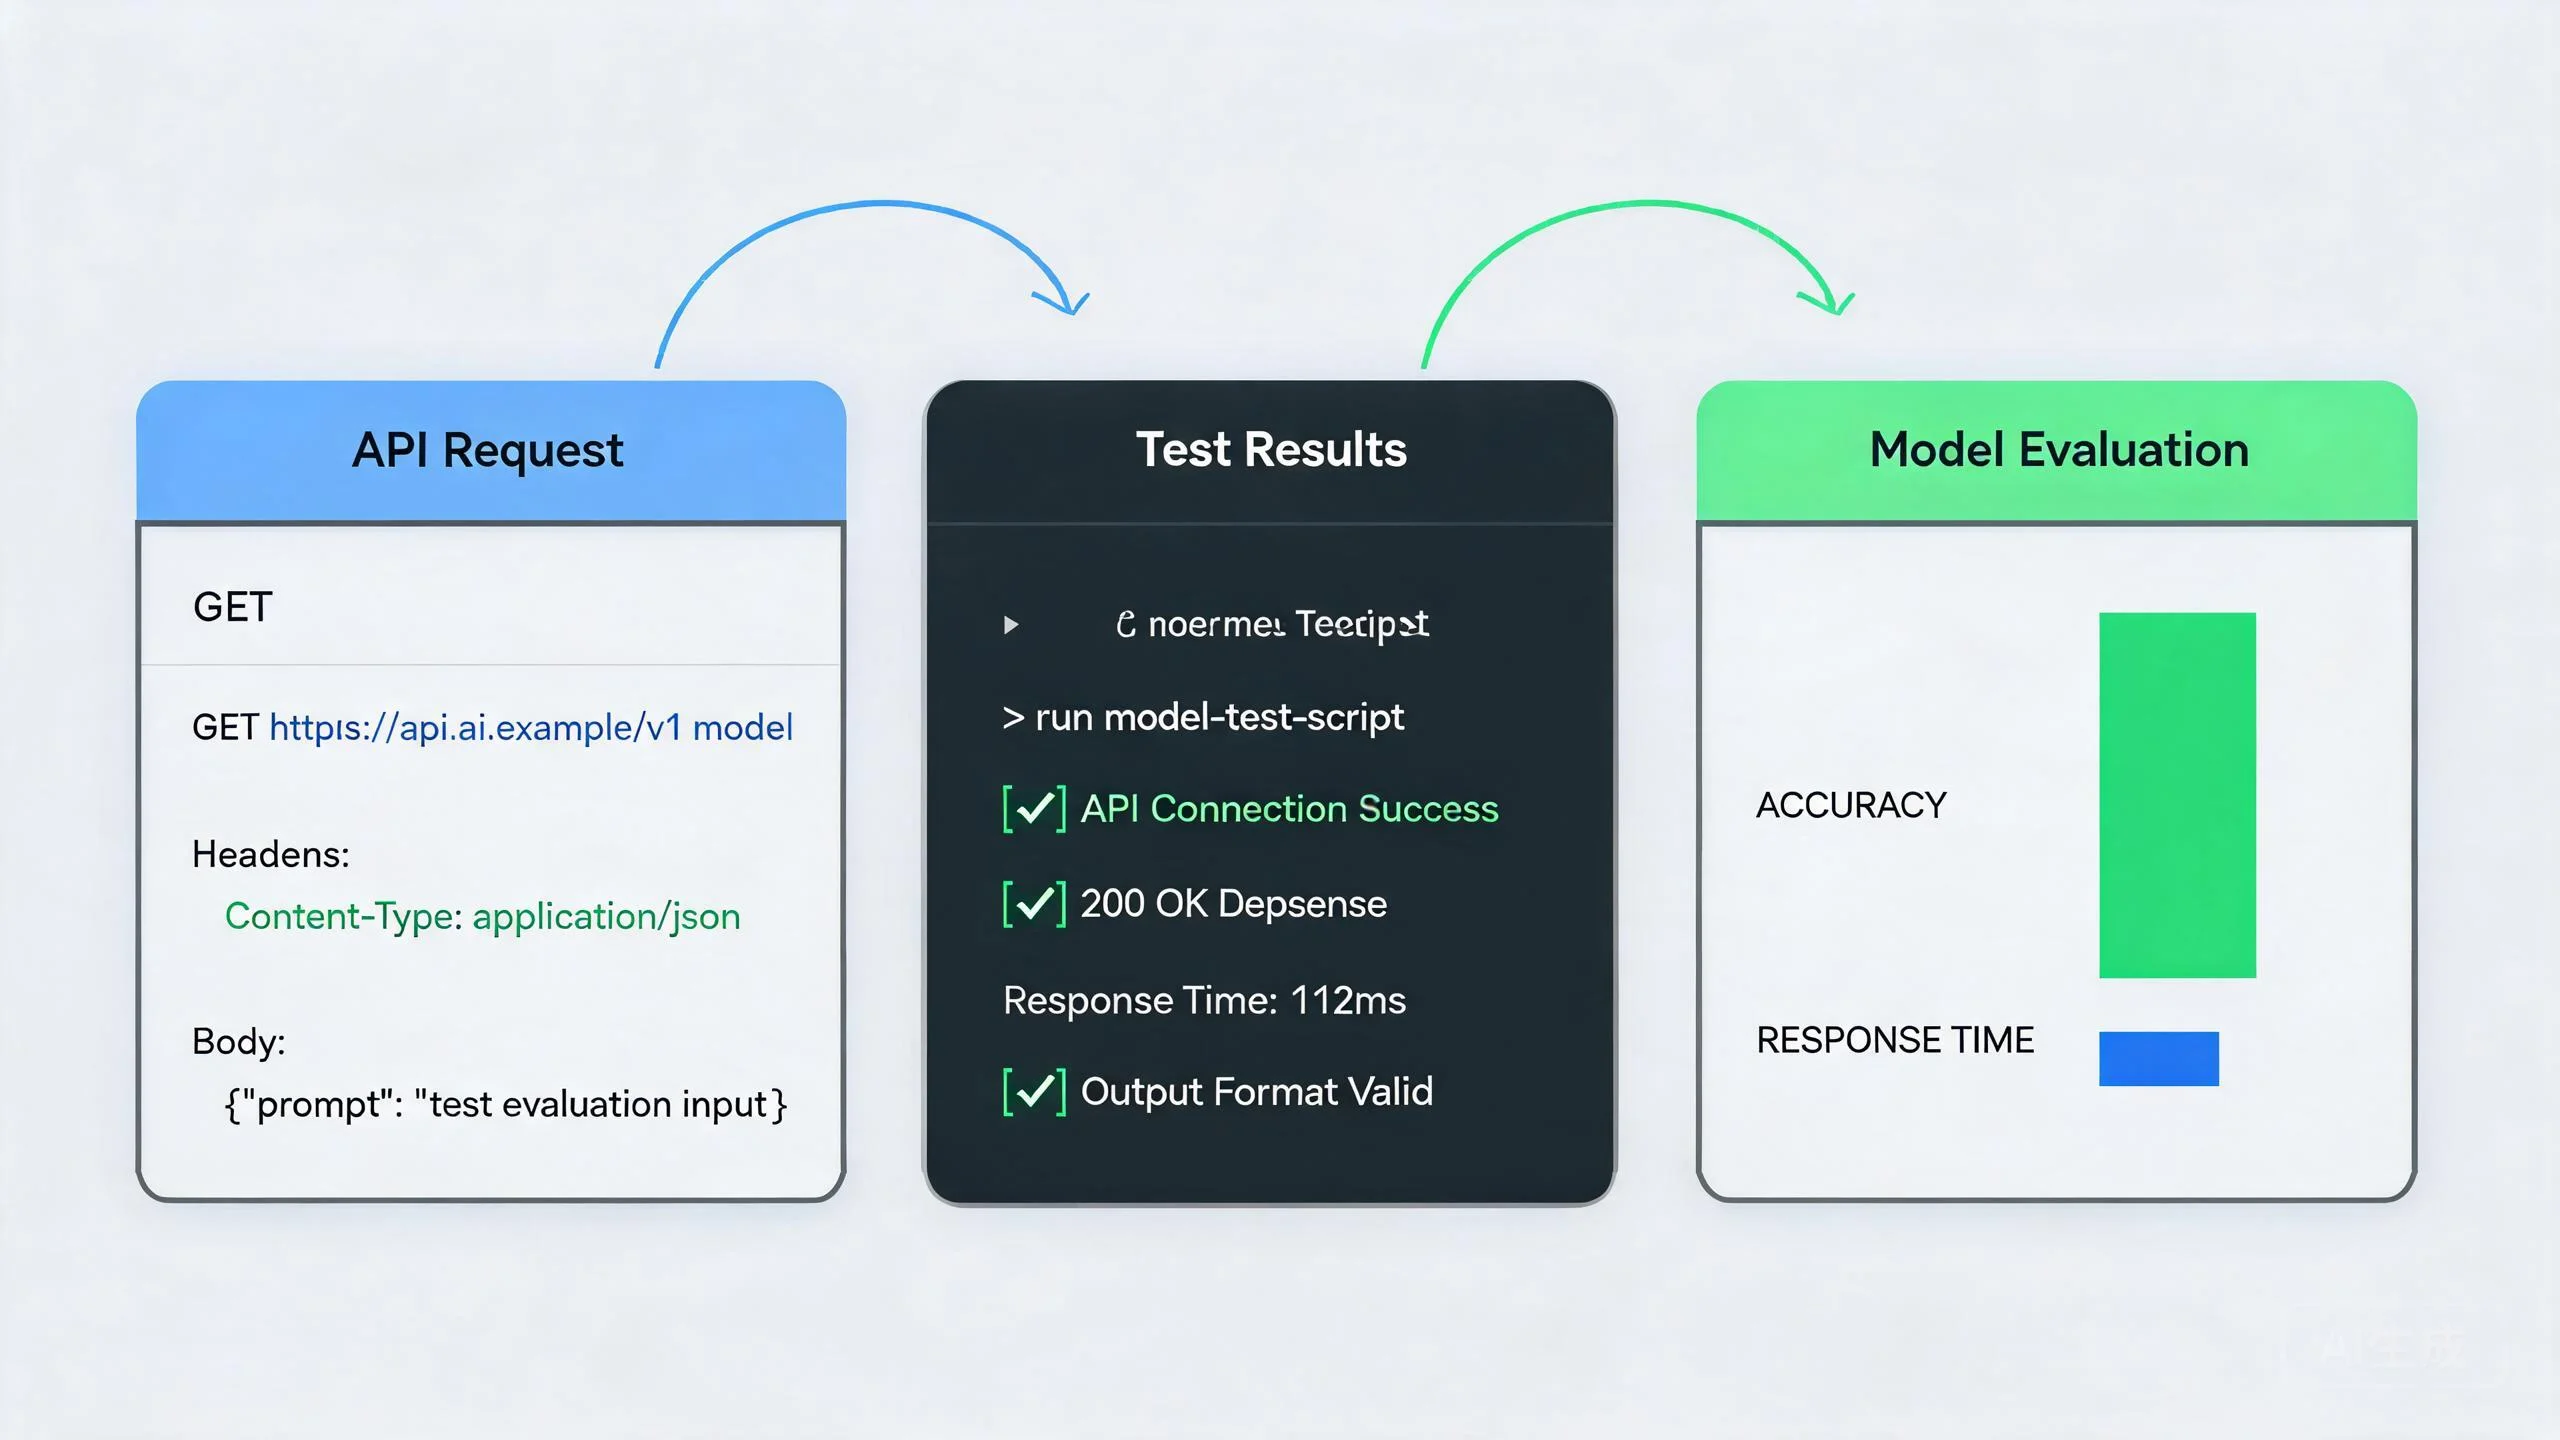
Un proceso de validación práctico incluye los siguientes pasos:
Abra la página del modelo GLM-5.3 y copie el ID exacto del modelo de SiliconFlow.
Ejecute un prompt de programación representativo en el Playground.
Defina las pruebas o criterios de aceptación que determinan si el Output es utilizable.
Cree una clave de API de SiliconFlow y conecte el modelo a su entorno de evaluación existente.
Repita la prueba en múltiples tareas y configuraciones de razonamiento.
Compare la calidad de la completación, la latencia, el uso de tokens, los reintentos y el tiempo de corrección manual.
El SDK de OpenAI se puede utilizar con el endpoint compatible de SiliconFlow. Almacene la clave de la API y el ID actual del modelo en variables de entorno en lugar de colocarlos directamente en la aplicación:
Establezca SILICONFLOW_GLM53_MODEL_ID con el identificador exacto que se muestra en la página actual del modelo. Añada parámetros de razonamiento y herramientas solo después de confirmar que el despliegue de SiliconFlow admite su formato documentado.
Una evaluación significativa debería utilizar de 20 a 50 tareas representativas en lugar de un único prompt exitoso. Mida:
Tasa de aceptación de tareas
Resultados de pruebas unitarias y de integración
Llamadas a herramientas inválidas o innecesarias
Latencia de extremo a extremo
Uso de Input, Input en caché y Output
Correcciones manuales y cambios fuera de alcance
El endpoint unificado de SiliconFlow permite a los equipos probar múltiples modelos disponibles a través de un patrón de API coherente. El Playground admite la inspección inicial, mientras que la API Serverless permite la evaluación sin necesidad de aprovisionar una infraestructura de inferencia independiente.
El mismo endpoint también se puede configurar en herramientas de programación compatibles. SiliconFlow proporciona instrucciones de configuración para Cline y Roo Code.
Decida si GLM-5.3 se adapta a su flujo de trabajo de desarrollo
GLM-5.3 es un candidato sólido para la depuración a escala de repositorio, el trabajo en terminales, agentes de múltiples herramientas y tareas de ingeniería de larga duración. Se adapta peor a flujos de trabajo visuales, autocompletado instantáneo y solicitudes de gran volumen donde la velocidad de respuesta importa más que el razonamiento profundo.
Pruebe tareas representativas en el Playground de SiliconFlow, luego mida la tasa de completación, la precisión de las llamadas a herramientas, la latencia, el uso de tokens y el esfuerzo de revisión a través de la API. Utilice GLM-5.3 allí donde sus capacidades de agente produzcan mejores resultados aceptados, derivando el trabajo rutinario a modelos más rápidos cuando sea apropiado.
Preguntas frecuentes sobre GLM-5.3
P1. ¿Se puede alojar localmente GLM-5.3?
No. A fecha de 22 de agosto de 2026, no se han liberado los pesos públicos de GLM-5.3 para alojamiento local general. El acceso a través de API y plataformas alojadas está disponible, pero los desarrolladores deben esperar a la tarjeta de modelo y licencia oficiales antes de planificar un despliegue local o aplicar los términos de la licencia de GLM-5.2 a GLM-5.3.
Q2. ¿Qué lenguajes de programación admite GLM-5.3?
No se ha publicado ninguna matriz completa de lenguajes de programación. GLM-5.3 es un modelo de programación general en lugar de un compilador específico de un lenguaje. Pruébelo con sus lenguajes, frameworks, gestores de paquetes, herramientas de construcción y convenciones de repositorio reales antes de esperar un rendimiento constante en diferentes pilas tecnológicas.
Q3. ¿Cuál es el límite de conocimiento de GLM-5.3?
Z.ai no ha revelado públicamente una fecha específica de límite de conocimiento. Trate la información sobre frameworks, librerías y seguridad sensible a la versión como potencialmente desactualizada. Proporcione documentación actualizada a través de prompts o recuperación de información, y verifique el código generado con la documentación oficial mantenida, los registros de cambios y los registros de paquetes.
Q4. ¿Se puede ajustar (fine-tune) GLM-5.3?
Actualmente no hay documentado ningún flujo de trabajo público de ajuste para GLM-5.3. Los desarrolladores pueden controlar el comportamiento a través de instrucciones del sistema, ejemplos, definiciones de herramientas, contexto recuperado y esfuerzo de razonamiento. No asuma que el soporte de ajuste disponible para otra versión de GLM se aplica también a este modelo.
Q5. ¿Puede GLM-5.3 funcionar con repositorios privados?
Sí. Un agente de programación autorizado puede proporcionar a GLM-5.3 archivos seleccionados de un repositorio privado. Los equipos deben minimizar el contexto transmitido, eliminar credenciales, restringir los permisos de las herramientas y revisar los términos actuales de retención, seguridad, control de acceso y procesamiento de datos del proveedor del despliegue antes de utilizar código propietario.