DeepSeek V4 Pro vs. GLM 5.3: ¿cuál deberías elegir para programar y crear agentes?
Índice de contenidos
DeepSeek V4 Pro es el punto de partida más rentable en SiliconFlow, especialmente para cargas de trabajo de codificación con grandes cantidades de contexto reutilizable. GLM 5.3 merece pruebas prioritarias cuando la ingeniería de software de largo alcance y la ejecución de agentes multipaso importan más que el precio más bajo por token.
La evidencia de las pruebas de rendimiento no respalda a un único modelo como el ganador universal. GLM 5.3 lidera varias evaluaciones de ingeniería de software y automatización, mientras que DeepSeek V4 Pro funciona mejor en algunas pruebas de repositorios y uso de herramientas. La decisión final debe depender del coste por tarea completada, la latencia, los reintentos y el tiempo de corrección humana en su propio flujo de trabajo.
DeepSeek V4 Pro frente a GLM 5.3 de un vistazo
Los siguientes detalles de despliegue y precios de SiliconFlow se verificaron el 9 de septiembre de 2026.
En SiliconFlow, DeepSeek-V4-Pro-0813 tiene tarifas más bajas en tokens de entrada no almacenada en caché, entrada almacenada en caché y de salida. Esta diferencia se vuelve más importante cuando un agente de codificación envía repetidamente el mismo contexto de repositorio, instrucciones del sistema o definiciones de herramientas.
GLM-5.3 cuesta un poco más por token. Sus resultados de evaluación lo convierten en un candidato relevante para agentes que deben trabajar en múltiples archivos, operar herramientas de desarrollo, inspeccionar resultados y revisar su enfoque a lo largo de una secuencia extendida. Ambos modelos están disponibles a través de la API Serverless de SiliconFlow. Esto permite a los equipos compararlos sin necesidad de mantener una infraestructura de inferencia separada o reconstruir una aplicación completa en torno a otro formato de API.
Área | DeepSeek V4 Pro | GLM 5.3 |
|---|---|---|
ID de modelo en SiliconFlow | deepseek-ai/DeepSeek-V4-Pro-0813 | zai-org/GLM-5.3 |
Mejor punto de partida | Codificación sensible al coste, trabajo con repositorios y contexto largo repetido | Ingeniería de largo alcance y flujos de trabajo de agentes multipaso |
Ventana de contexto | 1.049.000 tokens | 1.049.000 tokens |
Modalidad de entrada | Text | Text |
Llamada a herramientas | Soportado | Soportado |
Precio de entrada | $1,32 por millón de tokens | $1,40 por millón de tokens |
Precio de entrada almacenada en caché | $0,044 por millón de tokens | $0,26 por millón de tokens |
Precio de salida | $3,96 por millón de tokens | $4,40 por millón de tokens |
Rendimiento de codificación: qué miden realmente las pruebas de rendimiento
Las puntuaciones de las pruebas de rendimiento ayudan a reducir el orden de las pruebas, pero no demuestran qué modelo funcionará mejor dentro de un agente de codificación específico. Los resultados pueden cambiar con el arnés del agente, la configuración del razonamiento, la estrategia de gestión del contexto, los permisos de las herramientas, el tiempo de espera y el presupuesto de tokens.
Las siguientes cifras provienen de la evaluación de GLM-5.3 publicada por Z.ai. Comparan GLM 5.3 con DeepSeek-V4-Pro-0813 en versiones de pruebas de rendimiento específicas. Estos son resultados reportados por el proveedor en lugar de una prueba independiente de los dos endpoints de SiliconFlow.
Prueba de rendimiento | DeepSeek V4 Pro | GLM 5.3 | Capacidad principal probada |
|---|---|---|---|
Terminal-Bench 2.1 | 87.9 | 88.2 | Trabajo multipaso en entornos de terminal |
DeepSWE v1.1 | 62.7 | 66.9 | Trabajo de largo alcance en repositorios de software activos |
NL2Repo | 61.1 | 58.0 | Implementación a nivel de repositorio a partir de requisitos de lenguaje natural |
Toolathlon Verified | 74.1 | 73.0 | Selección y secuenciación de herramientas en flujos de trabajo realistas |
AutomationBench v1.0.6 | 43.2 | 48.2 | Tareas extendidas de automatización de flujos de trabajo |
Agents’ Last Exam CLI | 25.7 | 28.5 | Trabajo profesional verificable completado a través de un agente de CLI |
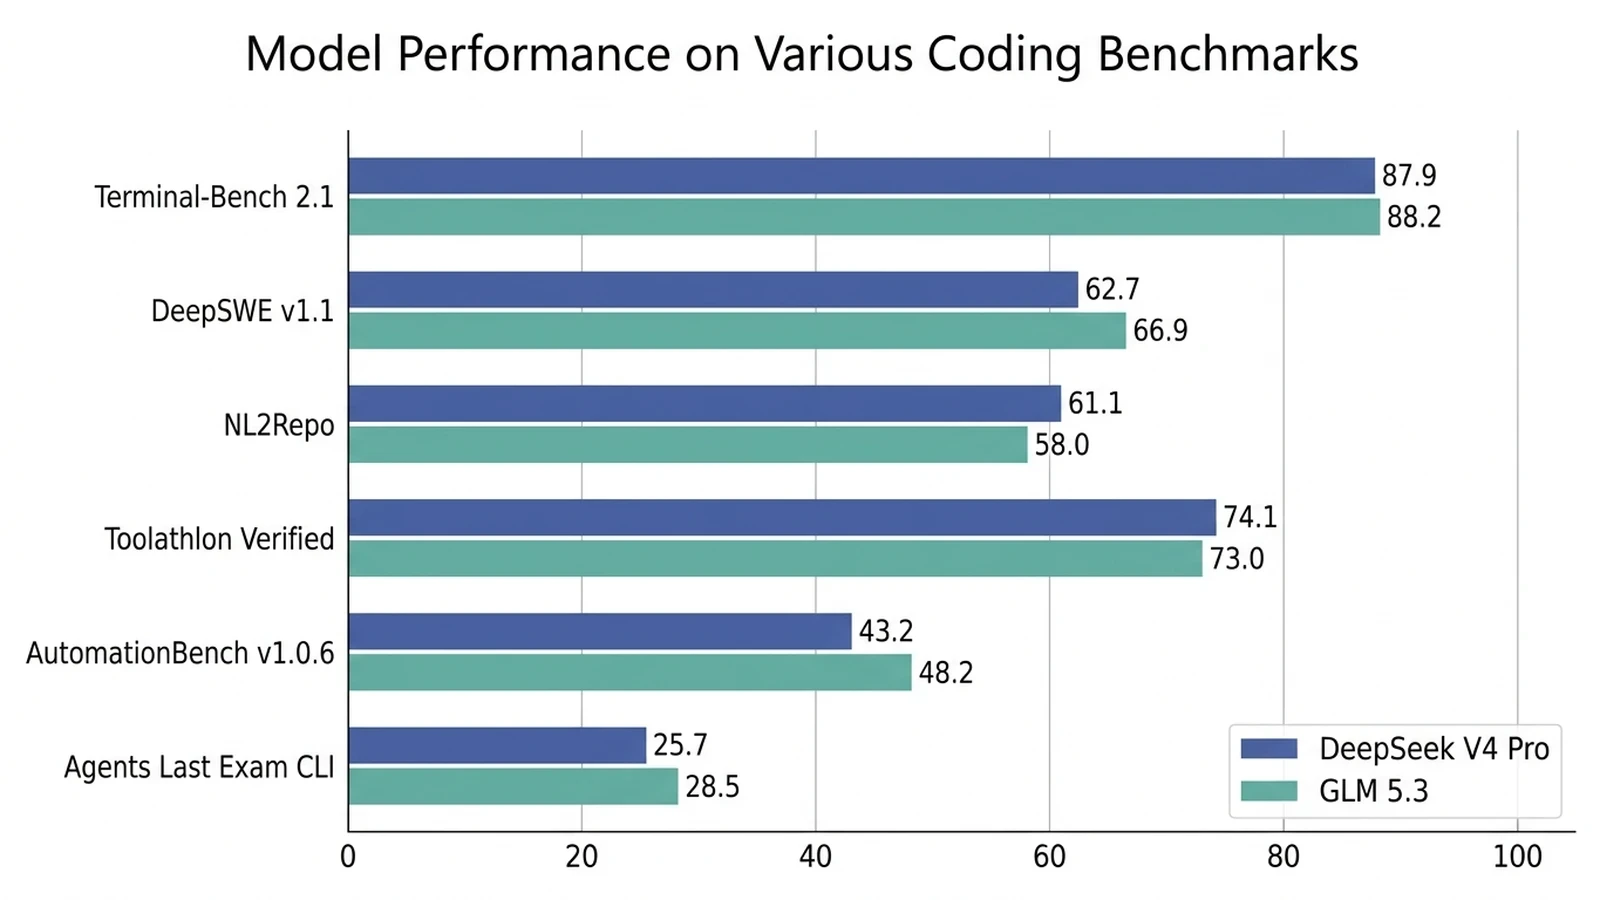
GLM 5.3 tiene la puntuación reportada más alta en DeepSWE v1.1, AutomationBench y Agents’ Last Exam CLI. DeepSeek V4 Pro lidera en NL2Repo y Toolathlon Verified. La diferencia de 0,3 puntos en Terminal-Bench 2.1 es demasiado pequeña para respaldar una regla general de selección de modelos sin pruebas repetidas.
Los nombres de las pruebas de rendimiento también representan diferentes tipos de trabajo de codificación.
DeepSWE v1.1 evalúa a los agentes en tareas de ingeniería originales y de largo alcance de repositorios activos. Las soluciones se califican a partir del código confirmado en entornos limpios. Esto lo hace más relevante para la implementación de características y correcciones de múltiples archivos que una prueba de rendimiento basada en fragmentos de código aislados.
Terminal-Bench evalúa si un agente puede completar un trabajo dentro de entornos de terminal. Una tarea puede requerir inspección de archivos, comandos de shell, gestión de dependencias, depuración y verificación de artefactos. El resultado refleja, por tanto, tanto la capacidad del modelo como el arnés del agente que lo rodea.
Toolathlon Verified mide si los agentes pueden seleccionar, secuenciar y utilizar herramientas en flujos de trabajo de software realistas. Proporciona una señal útil para la orquestación de herramientas, pero no garantiza que un modelo siga los esquemas y las reglas de negocio de su aplicación.
Agents’ Last Exam cubre flujos de trabajo profesionales más largos con resultados verificables. Su subconjunto de CLI es relevante para agentes generales que deben recopilar información, modificar archivos, utilizar herramientas y entregar un resultado finalizado.
Las versiones de las pruebas de rendimiento deben mantenerse separadas. Terminal-Bench 3.0 contiene tareas más difíciles y variadas que Terminal-Bench 2.1. Una puntuación reportada en la versión 3.0 no debe compararse directamente con una puntuación de la versión 2.1.
Uso de herramientas y tareas de agentes multipaso
Ambos modelos admiten la llamada a funciones a través de SiliconFlow. Pueden seleccionar una función, generar sus argumentos, recibir el resultado y continuar trabajando a través de pasos adicionales utilizando la API de Chat Completions compatible con OpenAI. Una etiqueta de compatibilidad con herramientas no muestra con qué fiabilidad funcionará un modelo con un agente. Las pruebas de producción deben verificar si cada modelo puede:
Seleccionar la función correcta cuando varias herramientas tienen propósitos similares.
Generar argumentos que superen la validación de esquemas y reglas de negocio.
Preservar rutas de archivos, ID de tareas y otros estados a lo largo de múltiples llamadas.
Reconocer comandos fallidos en lugar de continuar a partir de resultados inválidos.
Interpretar la salida de la prueba y modificar su implementación.
Detenerse después de cumplir con los criterios de aceptación.
Solicitar aprobación antes de una acción irreversible.
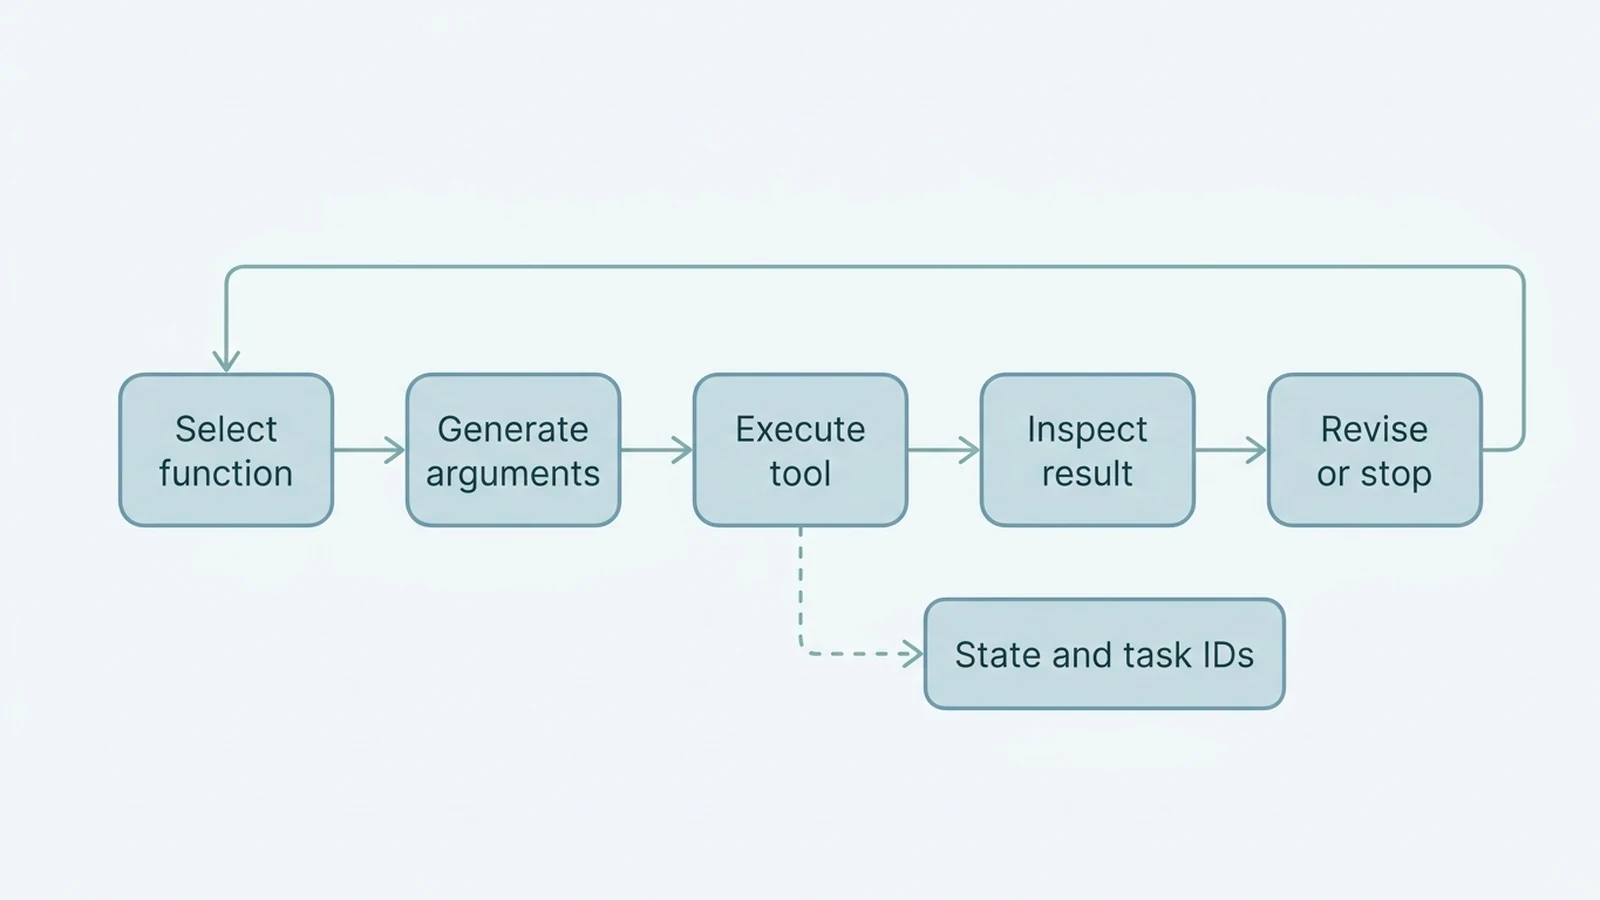
Los argumentos de herramienta generados siempre deben ser validados antes de su ejecución. Aplique los tipos esperados, rechace campos desconocidos, restrinja rutas accesibles y limite comandos, reintentos y solicitudes externas. Estos controles son necesarios incluso cuando un modelo alcanza una alta puntuación en las pruebas de uso de herramientas.
La gestión del estado también afecta al resultado. Una ventana de contexto larga puede preservar más contenido de repositorio e historial de herramientas, pero un agente aún necesita identificar qué información sigue siendo relevante. Almacene las decisiones importantes y los resultados de las pruebas de forma explícita en lugar de esperar que el modelo los recupere de una transcripción grande y no diferenciada.
Para una comparación útil, divida la evaluación en al menos dos grupos de tareas:
Tareas de codificación, como corregir pruebas, implementar características y refactorizar varios módulos.
Tareas de agentes, como recopilar información, llamar a múltiples herramientas, cambiar el estado externo y verificar el resultado final.
Esta separación muestra si los fallos se originan en la generación de código, la orquestación de herramientas, la gestión del estado o la verificación final.
Coste de API y latencia en cargas de trabajo comparables
Los precios actuales de SiliconFlow Serverless otorgan a DeepSeek V4 Pro la tarifa más baja por token en las tres categorías de facturación.
Categoría de token | DeepSeek V4 Pro | GLM 5.3 |
|---|---|---|
Entrada no almacenada en caché | $1,32/M | $1,40/M |
Entrada almacenada en caché | $0,044/M | $0,26/M |
Salida | $3,96/M | $4,40/M |
Para un uso equivalente de tokens, el precio de entrada no almacenada en caché de DeepSeek V4 Pro es aproximadamente un 5,7% más bajo, mientras que su precio de salida es un 10% más bajo. Su tarifa de entrada almacenada en caché es aproximadamente un 83,1% más baja.
La fórmula del coste por solicitud es:
Coste de la solicitud = coste de entrada no almacenada en caché + coste de entrada almacenada en caché + coste de salida
Considere un lote hipotético de 1.000 tareas de agentes de codificación. Cada tarea procesa 50.000 tokens de entrada y genera 10.000 tokens de salida.
Escenario | DeepSeek V4 Pro | GLM 5.3 |
|---|---|---|
Sin entrada almacenada en caché | 0,05 × $1,32 + 0,01 × $3,96 = $0,01056 por tarea | 0,05 × $1,40 + 0,01 × $4,40 = $0,114 por tarea |
40.000 tokens de entrada almacenada en caché | 0,01 × $1,32 + 0,04 × $0,044 + 0,01 × $3,96 = $0,05456 por tarea | 0,01 × $1,40 + 0,04 × $0,26 + 0,01 × $4,40 = $0,0684 por tarea |
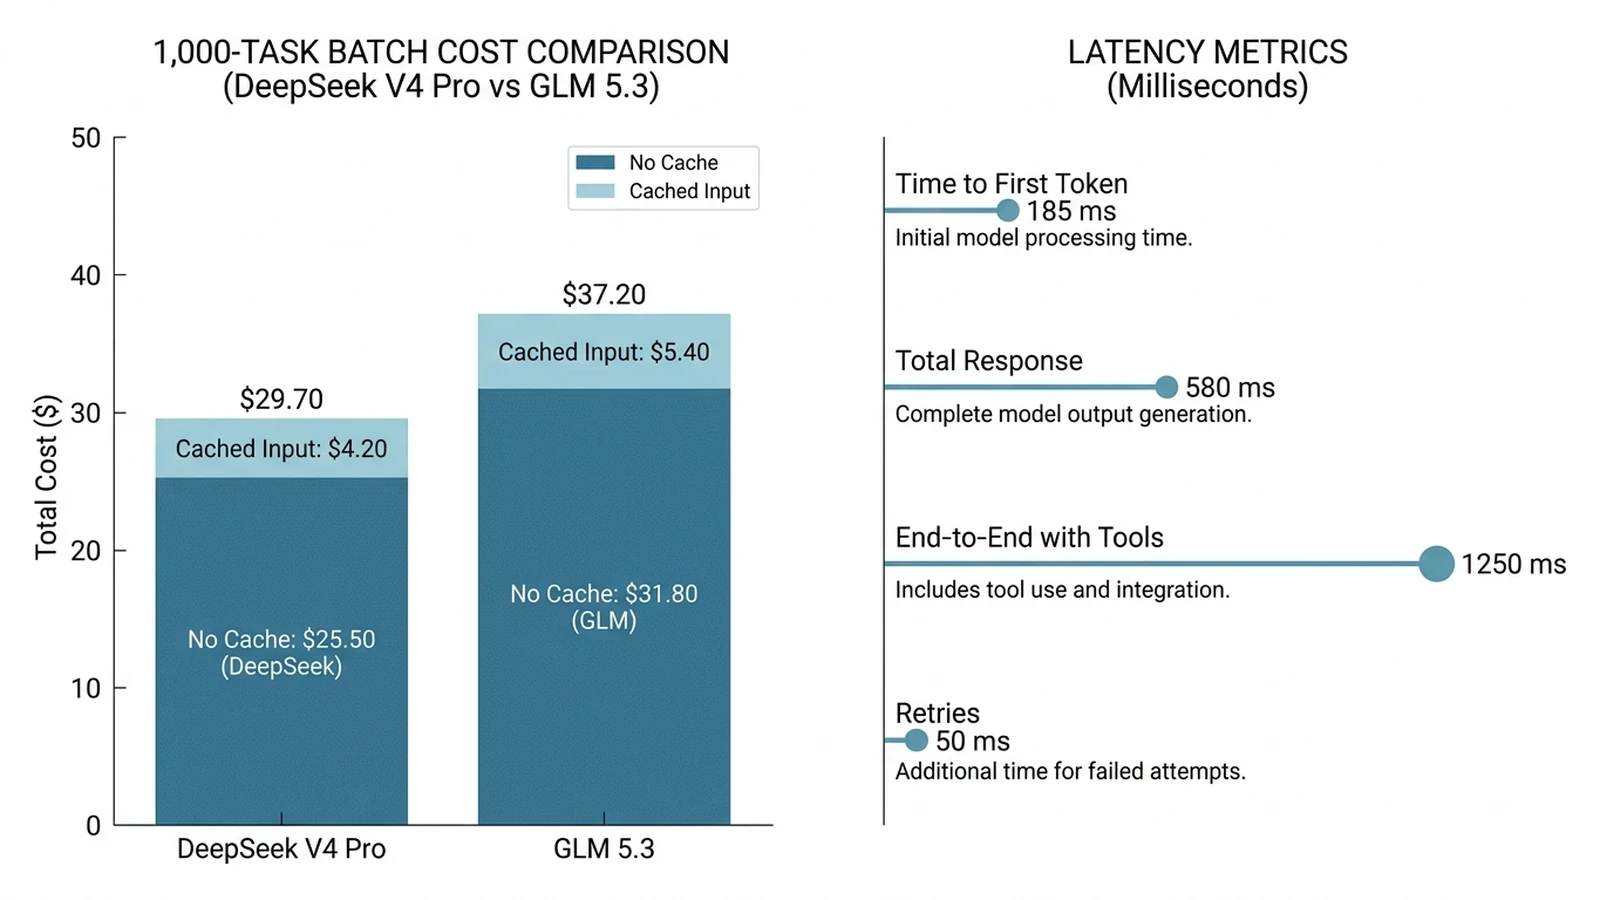
El segundo escenario asume que 40.000 tokens en cada solicitud califican para la facturación de entrada almacenada en caché. La elegibilidad real y las tasas de acierto dependen de la estructura de la solicitud y del comportamiento de la plataforma.
Estas cifras también asumen que ambos modelos utilizan la misma cantidad de tokens y completan cada tarea con éxito. Los agentes de codificación reales pueden producir diferentes longitudes de salida, realizar llamadas adicionales a herramientas o reintentar trabajos fallidos.
Por lo tanto, el precio del token debe evaluarse junto con el coste por tarea aceptada:
Coste por tarea aceptada = gasto total en API y reintentos ÷ tareas que superan la validación
Supongamos que GLM 5.3 cuesta más por solicitud pero completa tareas significativamente más difíciles sin intervención. Su coste efectivo podría ser menor. Si su tasa de éxito es similar, las tarifas más bajas de DeepSeek V4 Pro se vuelven más importantes.
La latencia debe medirse con el mismo enfoque a nivel de carga de trabajo. El número de parámetros y las clasificaciones en las pruebas de rendimiento no determinan la rapidez con la que un endpoint alojado finalizará una tarea. Registre:
Tiempo medio y P95 hasta el primer token.
Tiempo total de respuesta medio y P95.
Tiempo de extremo a extremo, incluyendo herramientas y pruebas.
Tokens de salida generados por tarea.
Tasa de finalización en el primer intento.
Fallos de validación en llamadas a herramientas.
Reintentos requeridos antes de la aceptación.
Coste por resultado aceptado.
Mantenga coherentes las instantáneas de los repositorios, los prompts, las herramientas, los límites de salida, los tiempos de espera y las pruebas de aceptación. Ejecute cada tarea más de una vez, ya que el comportamiento del agente y el rendimiento del endpoint pueden variar entre solicitudes.
¿Qué modelo se adapta a su flujo de trabajo de codificación?
Elija DeepSeek V4 Pro como el primer modelo a probar cuando:
Prevea un alto volumen de solicitudes de codificación.
Se reutilizará el mismo prompt del sistema, definiciones de herramientas o contexto de repositorio.
El coste de entrada y salida debe seguir siendo predecible.
La implementación en repositorios y el uso de herramientas son fundamentales para el flujo de trabajo.
El modelo servirá como nivel predeterminado en un sistema enrutado.
Elija GLM 5.3 como el primer modelo a probar cuando:
Las tareas abarquen regularmente varios archivos o módulos.
El agente deba trabajar a través de bucles extendidos de implementación y verificación.
El trabajo de ingeniería al estilo DeepSWE se asemeje a su carga de trabajo de producción.
La automatización del flujo de trabajo importe tanto como la generación de código.
Una mayor tasa de tareas completadas pueda justificar un precio de token más alto.
Un sistema enrutado puede utilizar ambos modelos sin tratar a ninguno de ellos como la respuesta a todas las tareas. Comience con DeepSeek V4 Pro para trabajos predecibles y de gran volumen. Derive las tareas fallidas o inusualmente complejas a GLM 5.3 cuando su evaluación demuestre que mejora las tasas de finalización.
Construya la regla de enrutamiento a partir de resultados reales. Un conjunto de evaluación práctico puede contener entre 30 y 100 tareas representativas divididas por lenguaje, tamaño del repositorio, complejidad y uso de herramientas requerido. Califique cada salida con pruebas o criterios de aceptación explícitos en lugar de preferencias subjetivas.
La decisión entre DeepSeek V4 Pro y GLM 5.3 se reduce en última instancia a la economía de tareas verificada. DeepSeek V4 Pro ofrece los precios de API actuales más bajos en SiliconFlow. GLM 5.3 muestra resultados reportados por el proveedor más sólidos en varias pruebas de rendimiento de agentes y codificación de largo alcance. Elija el modelo que produzca más trabajo aceptado con una latencia y un coste total aceptables.
Preguntas comunes sobre DeepSeek V4 Pro frente a GLM 5.3 de un vistazo
Q1. ¿Son DeepSeek V4 Pro y GLM 5.3 modelos de pesos abiertos?
Sí. Ambos publican pesos descargables. DeepSeek-V4-Pro-0813 utiliza la licencia MIT, mientras que GLM 5.3 utiliza su propia licencia de modelo nominativa. Revise los términos aplicables antes de modificar, redistribuir o alojar comercialmente por cuenta propia cualquiera de los modelos.
Q2. ¿Pueden DeepSeek V4 Pro y GLM 5.3 procesar imágenes en SiliconFlow?
No. Sus despliegues actuales en SiliconFlow aceptan entrada de texto. Un flujo de trabajo que dependa de capturas de pantalla, diagramas o interfaces renderizadas debe enviar esos recursos a un modelo de visión compatible antes de pasar los hallazgos relevantes al agente de codificación.
Q3. ¿Reemplaza una ventana de contexto de un millón de tokens a la recuperación de código?
No. Una ventana más grande aumenta la capacidad, pero no garantiza que cada archivo reciba la misma atención. Los mapas de repositorios, la recuperación consciente de dependencias, la selección específica de archivos y la compactación del contexto pueden mejorar la relevancia al tiempo que reducen el uso de tokens.
Q4. ¿Se puede cambiar entre los modelos a través de la misma integración de API?
Sí. Ambos son accesibles a través de la API compatible con OpenAI de SiliconFlow utilizando diferentes ID de modelo. Mantenga configurables los ajustes de solicitud específicos del modelo y el manejo de salidas, y luego vuelva a ejecutar las pruebas de validación cada vez que cambie el modelo o la versión.
Q5. ¿Cómo debe manejar un agente de codificación una respuesta HTTP 429?
Reduzca la concurrencia y reintente con un retroceso exponencial e incertidumbre (jitter). El ejemplo 429 documentado de SiliconFlow identifica un límite de tokens por minuto, pero las aplicaciones deben inspeccionar el mensaje devuelto antes de decidir si reintentar y cuándo hacerlo.