GLM-5.3 frente a GLM-5.3-Flash: comparación de programación, Input Multimodal y coste de API
Índice de contenidos
GLM-5.3-Flash es un punto de partida práctico para la programación de gran volumen, el desarrollo visual y las cargas de trabajo donde el coste de la API importa. Para ingeniería difícil exclusivamente de texto, pruebe GLM-5.3 y utilícelo donde una mayor tasa de tareas aceptadas justifique el coste adicional de tokens. En SiliconFlow, ambos modelos tienen una ventana de contexto de 1.049K tokens y admiten la llamada a herramientas, pero actualmente solo GLM-5.3-Flash está documentado para la entrada de imágenes.
Por lo tanto, la elección correcta depende de algo más que el nombre del modelo. Comience con el tipo de entrada, luego considere la dificultad de la tarea, la cobertura de validación, la longitud de la salida y el coste de los reintentos o la corrección humana.
GLM-5.3 y GLM-5.3-Flash: Las diferencias que importan
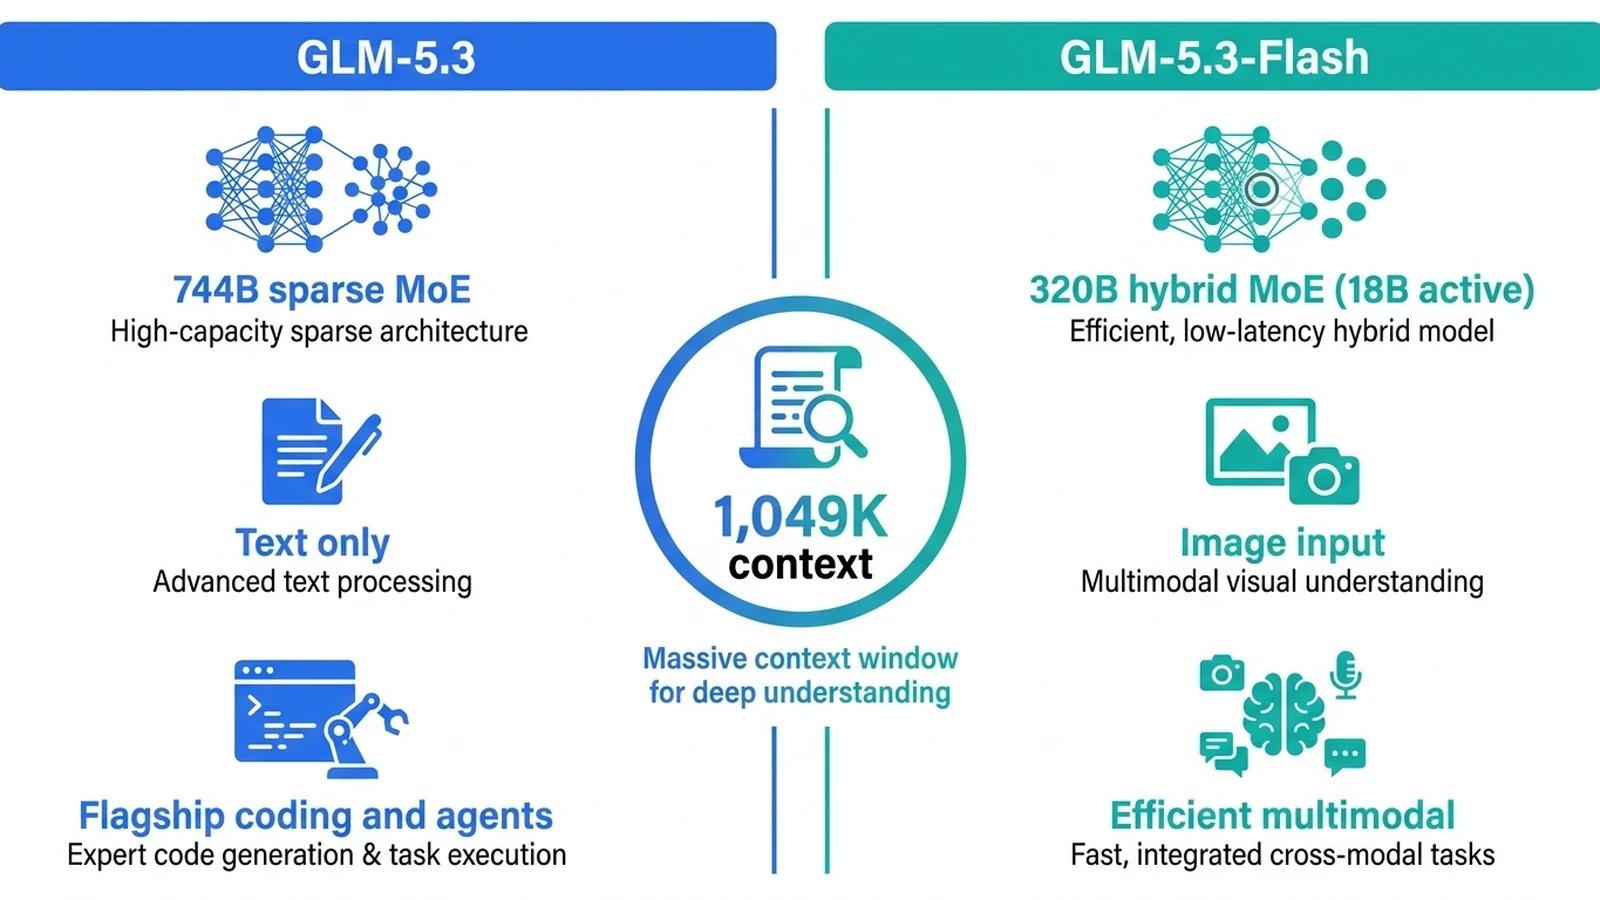
GLM-5.3 es el modelo insignia de Z.ai para ingeniería de software compleja y trabajo de agentes a largo plazo. GLM-5.3-Flash utiliza una arquitectura diferente y más eficiente en computación y añade comprensión multimodal nativa. No es simplemente un GLM-5.3 con una configuración de razonamiento más baja.
La siguiente comparación refleja los modelos disponibles en SiliconFlow a partir del 9 de septiembre de 2026.
Categoría | GLM-5.3 | GLM-5.3-Flash | Implicación práctica |
|---|---|---|---|
ID de modelo de SiliconFlow | zai-org/GLM-5.3 | zai-org/GLM-5.3-Flash | Puede cambiar de modelo modificando el ID del modelo en el mismo flujo de trabajo de la API. |
Posicionamiento | Modelo insignia de programación y agentes | Modelo eficiente multimodal de programación y agentes | Utilice la dificultad de la tarea y el tipo de entrada para elegir, en lugar de tratar a Flash como una degradación automática. |
Arquitectura | Mezcla dispersa de expertos (MoE) de 744B | Mezcla híbrida de expertos (MoE) de 320B con 18B parámetros activos | Flash está diseñado para reducir el coste de inferencia, especialmente en contextos largos. |
Longitud de contexto en SiliconFlow | 1.049K tokens | 1.049K tokens | Cualquier modelo puede aceptar repositorios grandes o historiales largos de agentes, sujeto a límites prácticos de solicitudes. |
Entrada de imágenes en SiliconFlow | No admitido | Admitido | Flash puede inspeccionar capturas de pantalla, diagramas e interfaces renderizadas sin necesidad de un modelo de visión independiente. |
Llamada a herramientas en SiliconFlow | Admitido | Admitido | Ambos pueden operar dentro de agentes de programación que exponen funciones y herramientas de desarrollo. |
Precio de entrada | $1,40 por millón de tokens | $0,15 por millón de tokens | Flash es menos costoso para el contexto de repositorio repetido. |
Precio de entrada almacenada en caché | $0,26 por millón de tokens | $0,03 por millón de tokens | Ambos recompensan la reutilización de prompts estables y contexto de código, pero a tasas diferentes. |
Precio de salida | $4,40 por millón de tokens | $0,50 por millón de tokens | Las trazas largas de razonamiento y la generación de código amplían la diferencia de coste. |
En SiliconFlow, puede acceder a GLM-5.3 y GLM-5.3-Flash a través de los ID de modelo que se muestran arriba. Verifique las tarifas de tokens más recientes al pronosticar el gasto de producción, ya que los precios pueden cambiar.
La arquitectura ayuda a explicar la brecha de precios, pero no determina qué modelo completará sus propias tareas con éxito. Un modelo de menor coste que provoque varios reintentos, una corrección exhaustiva por parte del desarrollador o una escalada innecesaria puede costar más por resultado aceptado. Por el contrario, pagar por el modelo insignia para cada corrección de linter o solicitud de generación de pruebas puede desperdiciar presupuesto sin mejorar el resultado final.
Cómo afectan las entradas de imagen y vídeo a su elección
La modalidad de entrada establece la línea divisoria más clara. GLM-5.3 acepta texto, mientras que el despliegue en SiliconFlow de GLM-5.3-Flash admite explícitamente la entrada de imágenes. Eso convierte a Flash en la elección directa cuando la tarea depende de evidencia visual. Las tareas útiles de programación impulsadas por imágenes incluyen:
Reproducir un frontend a partir de capturas de pantalla aprobadas
Comparar una página renderizada con una referencia de diseño
Leer un diálogo de error que no está disponible como texto estructurado
Inspeccionar gráficos, diagramas de arquitectura o fallos visuales de pruebas
Comprobar cambios de diseño en varias capturas de pantalla de la ventana gráfica
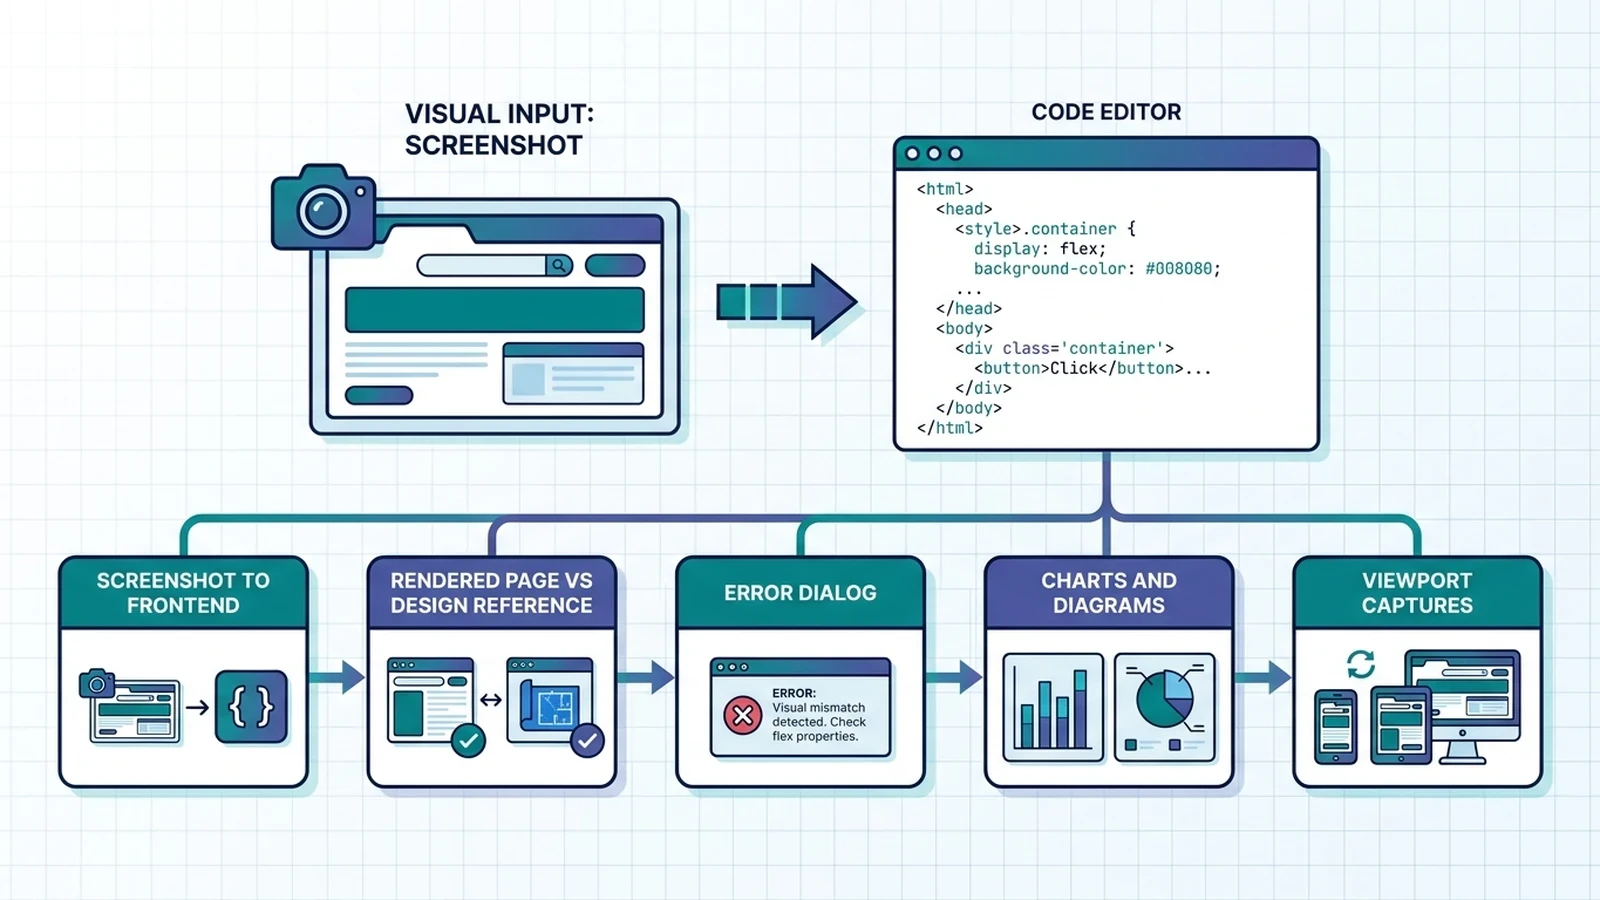
Las imágenes aún necesitan un contexto adecuado. Una captura de pantalla puede mostrar que un botón está mal colocado, pero puede que no revele el árbol de componentes, las reglas de puntos de interrupción o el estado que causó el problema. Incluya el código relevante, el comportamiento esperado, el tamaño de la ventana gráfica y los criterios de aceptación con la imagen.
El soporte de vídeo requiere más cuidado. La documentación de GLM-5.3-Flash de Z.ai describe que el modelo ascendente acepta entradas de vídeo, imágenes, texto y archivos. En SiliconFlow, GLM-5.3-Flash cuenta actualmente con soporte documentado para la entrada de imágenes, pero no se describe un formato de solicitud de vídeo sin procesar. La capacidad del modelo ascendente no debe tratarse como prueba de que el mismo formato de entrada está habilitado en cada endpoint alojado.
Para un flujo de trabajo de producción en SiliconFlow, confirme el manejo de vídeo con la documentación actual de la API y una pequeña prueba de endpoint antes de construir en torno a ella. Si el vídeo sin procesar no es compatible con la ruta de solicitud que utiliza, extraiga fotogramas representativos y una transcripción con marca de tiempo, y luego envíe esa evidencia a GLM-5.3-Flash. Este enfoque también le brinda más control sobre el uso de tokens y los momentos que el modelo inspecciona.
GLM-5.3 aún puede participar en un flujo de trabajo visual después del preprocesamiento. Flash puede convertir primero capturas de pantalla o fotogramas en un informe de defectos estructurado. GLM-5.3 puede luego razonar sobre ese texto cuando la corrección subyacente abarca varios servicios o requiere una decisión arquitectónica difícil.
Elección de un modelo para programación rutinaria e ingeniería compleja
Para GLM-5.3 frente a Flash para programación, el modelo insignia lidera varias evaluaciones exigentes de ingeniería de software, mientras que Flash funciona mejor en pruebas seleccionadas de uso de herramientas y automatización.
Benchmark | GLM-5.3 | GLM-5.3-Flash | Lo que sugiere el resultado |
|---|---|---|---|
88.2 | 84.3 | GLM-5.3 tiene la ventaja en tareas de agentes basadas en terminal. | |
DeepSWE v1.1 | 66.9 | 63.4 | GLM-5.3 lidera en la resolución de problemas de ingeniería de software. |
Toolathlon Verified | 73.0 | 78.4 | Flash funciona mejor en esta evaluación de uso de herramientas. |
AutomationBench v1.0.6 | 48.2 | 48.8 | Los resultados reportados están casi nivelados. |
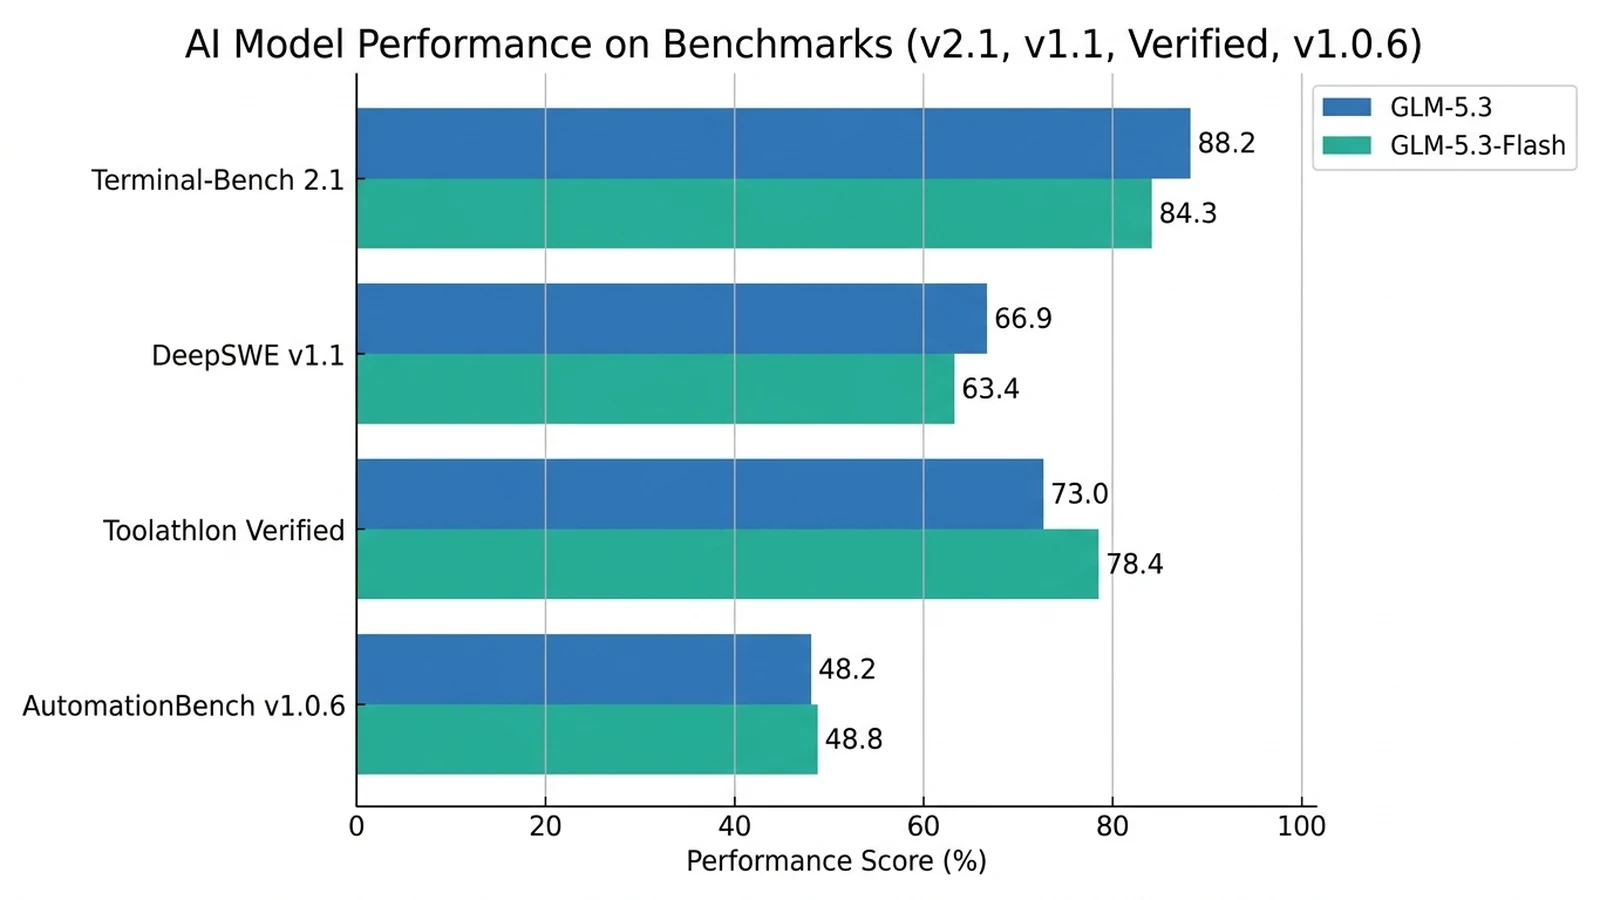
Las tarjetas de modelo de GLM-5.3 y GLM-5.3-Flash de Z.ai revelan configuraciones principales idénticas para estas evaluaciones. Por ejemplo, ambos resultados de Terminal-Bench 2.1 utilizan Claude Code 2.1.207, la misma configuración de muestreo, un límite de generación de 65.536 tokens y un tiempo de espera de seis horas. Los resultados aún son reportados por el proveedor, así que utilícelos como evidencia orientativa y pruebe ambos modelos con su propio entorno de agentes, herramientas y conjunto de tareas.
Carga de trabajo | Comenzar con | Por qué |
|---|---|---|
Generación de código repetitivo, documentación y pruebas unitarias | GLM-5.3-Flash | El trabajo suele ser fácil de validar y sensible al volumen. |
Refactorizaciones pequeñas y bien delimitadas | GLM-5.3-Flash | Las pruebas, las comprobaciones de tipos y los límites de diff pueden capturar muchos fallos de forma automática. |
Implementación de captura de pantalla a frontend | GLM-5.3-Flash | La referencia visual debe permanecer disponible para el modelo. |
Clasificación de problemas y depuración de primera pasada | GLM-5.3-Flash | Puede recopilar pruebas de forma económica antes de la escalada. |
Fallos interservicios con causas ambiguas | GLM-5.3 | Los resultados más sólidos del modelo insignia en evaluaciones de ingeniería difíciles pueden justificar el coste adicional. |
Cambios arquitectónicos con amplios efectos secundarios | GLM-5.3 | Los errores son costosos y la tarea exige un razonamiento sostenido a través de restricciones. |
Migración de alto riesgo o revisión sensible a la seguridad | GLM-5.3 con validación obligatoria | Utilice el modelo de mayor capacidad, pero mantenga las pruebas, los escáneres y la aprobación humana en el proceso. |
La distinción importante es la verificabilidad de la tarea. Flash es una opción predeterminada sólida cuando una comprobación determinista puede aceptar o rechazar su trabajo. El modelo insignia se vuelve más valioso cuando los requisitos están incompletos, los fallos son difíciles de detectar o una decisión incorrecta puede propagarse por todo el sistema.
Cree un conjunto de evaluación interna antes de trasladar el tráfico de producción. Incluya incidencias rutinarias, incidentes difíciles, tareas de contexto largo y casos de fallo conocidos. Registre el éxito en la primera pasada, el recuento de reintentos, los tokens de entrada y salida, la latencia, el tiempo de corrección del desarrollador y la aceptación final. Esto demuestra si el modelo insignia reduce los fallos y las correcciones lo suficiente como para justificar sus tarifas más altas.
Comparación de costes de API para la misma carga de trabajo
Los precios actuales de pago por uso de SiliconFlow hacen que GLM-5.3-Flash sea sustancialmente más barato por token. La diferencia real de presupuesto depende del equilibrio entre la nueva entrada, la entrada almacenada en caché y la salida generada.
Para cualquier modelo, el cálculo básico es:
Coste de API = [(U * Pu) + (C * Pc) + (O * Po)] / 1.000.000
Aquí, U representa los tokens de entrada no almacenados en caché, C los tokens de entrada almacenados en caché y O los tokens de salida. Pu, Pc y Po son los precios correspondientes por millón de tokens de entrada no almacenados en caché, entrada almacenada en caché y salida.
Considere una carga de trabajo mensual hipotética de 1.000 tareas de programación. Cada tarea utiliza 100.000 tokens de entrada y genera 10.000 tokens de salida. Sin entrada almacenada en caché, la comparación es:
Modelo | Coste de entrada para 100M tokens | Coste de salida para 10M tokens | Coste mensual total |
|---|---|---|---|
GLM-5.3 | $140,00 | $44,00 | $184,00 |
GLM-5.3-Flash | $15,00 | $5,00 | $20,00 |
Si el 60% de la entrada se sirve con la tarifa de entrada almacenada en caché, la misma carga de trabajo hipotética se convierte en:
Modelo | 40M Entrada no almacenada en caché | 60M Entrada almacenada en caché | 10M Salida | Coste mensual total |
|---|---|---|---|---|
GLM-5.3 | $56,00 | $15,60 | $44,00 | $115,60 |
GLM-5.3-Flash | $6,00 | $1,80 | $5,00 | $12,80 |
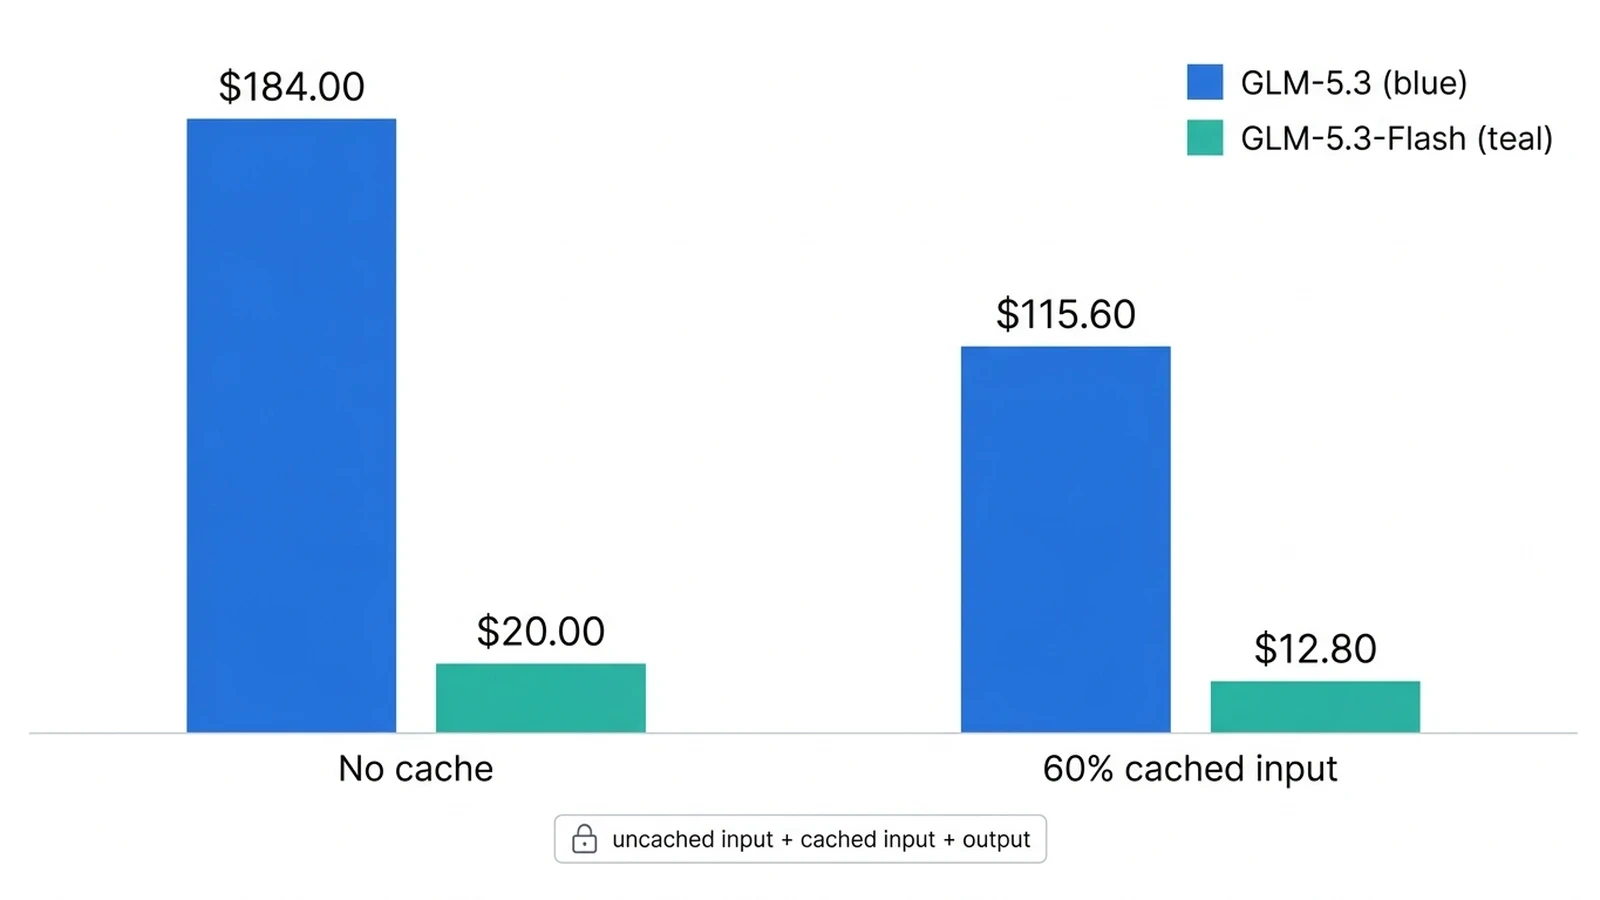
Estas cifras comparan volúmenes idénticos de tokens. No asumen que ambos modelos generen la misma cantidad de tokens o alcancen la misma tasa de aceptación. En un agente real, calcule el coste de cada llamada inicial, reintento y escalada, luego divida el gasto total de la API por la cantidad de tareas aceptadas:
Coste por tarea aceptada = coste total de llamadas iniciales, reintentos y escaladas / número de tareas aceptadas
Esta segunda métrica es más útil que el precio de los tokens por sí solo. Capta los casos en los que Flash completa una tarea rutinaria en el primer intento, así como los casos en los que una tarea difícil llega al modelo insignia tras una primera pasada fallida.
Cuándo usar un modelo o enrutar entre ambos
Una ruta de dos modelos puede ser más eficiente que enviar cada tarea al mismo modelo. También crea una ruta de escalada clara en lugar de pedir a los desarrolladores que elijan manualmente para cada solicitud.
Utilice la siguiente secuencia de enrutamiento:
Clasificar la entrada. Envíe las solicitudes que contengan capturas de pantalla u otras pruebas visuales requeridas a GLM-5.3-Flash. Envíe las solicitudes de solo texto a la siguiente decisión.
Estimar el riesgo de la tarea. Mantenga el trabajo rutinario, reversible y automáticamente verificable en Flash. Enrute las tareas de texto de alto impacto de arquitectura, seguridad, migración de datos o multisistema ambiguas a GLM-5.3. Para tareas visuales de alto riesgo, Flash puede extraer las pruebas visuales antes de que GLM-5.3 reciba un relevo basado en texto.
Ejecutar comprobaciones deterministas. Utilice pruebas, linting, comprobaciones de tipos, validación de esquemas, escaneos de seguridad y límites de archivos permitidos o tamaños de diff.
Escalar según la evidencia. Envíe las comprobaciones fallidas, los bucles de herramientas repetidos, los planes contradictorios o la ambigüedad no resuelta a GLM-5.3 junto con la evidencia del primer modelo y los resultados de las herramientas.
Medir la ruta completa. Realice un seguimiento del total de tokens y de los resultados aceptados en ambas llamadas. No evalúe el primer modelo de forma aislada si la escalada forma parte del diseño.
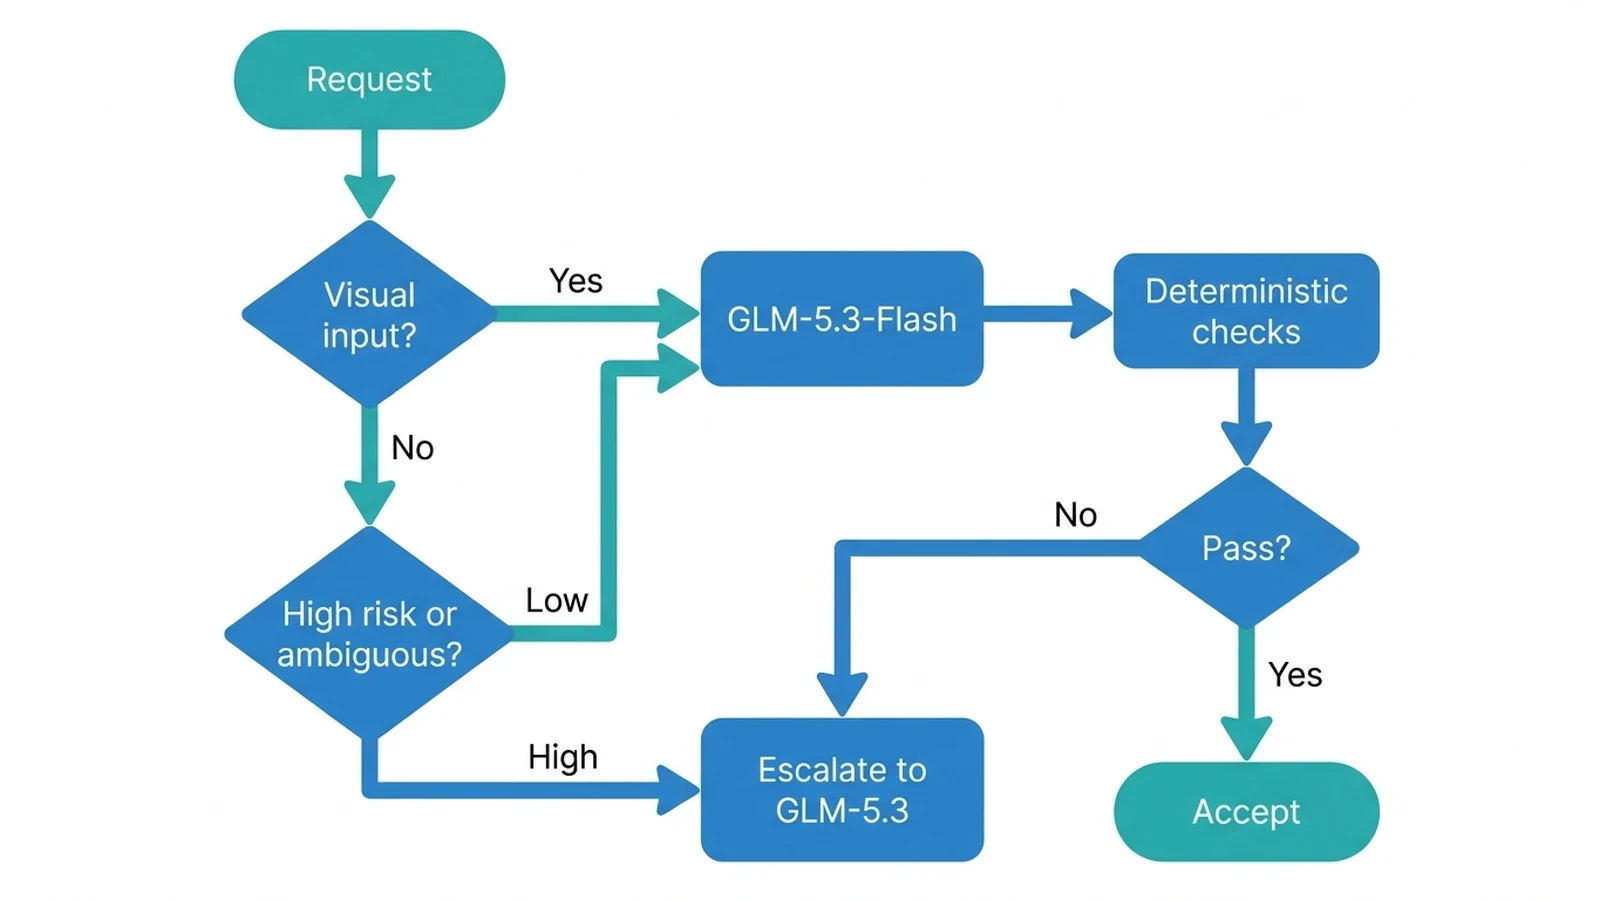
Ambos modelos están disponibles a través de la API de Chat Completions compatible con OpenAI de SiliconFlow. Una vez que las solicitudes visuales se han enrutado por separado, el siguiente ejemplo de solo texto selecciona un modelo en función del riesgo de la tarea y los resultados anteriores:
Este ejemplo mantiene deliberadamente la lógica de aceptación fuera de la llamada al modelo. Los sistemas de producción deben decidir la escalada a partir de los resultados de las pruebas, las comprobaciones de directivas y los metadatos de las tareas, en lugar de preguntar al primer modelo si su propia respuesta es correcta.
Para la mayoría de los equipos, la regla práctica es simple: use GLM-5.3-Flash como la vía predeterminada, consérvelo para tareas que requieran imágenes y promueva el trabajo difícil o fallido de solo texto a GLM-5.3. Revise los umbrales cuando cambie su combinación de tareas, precios o despliegues de modelos.
Preguntas comunes sobre GLM-5.3 y GLM-5.3-Flash: Las diferencias que importan
P1. ¿Se puede ajustar (fine-tune) alguno de los modelos en SiliconFlow?
No. El ajuste fino y Serverless LoRA no están admitidos actualmente para los despliegues serverless de GLM-5.3 o GLM-5.3-Flash. Elija otro despliegue admitido si la adaptación es un requisito indispensable.
P2. ¿Puede GLM-5.3-Flash generar imágenes?
No. GLM-5.3-Flash puede analizar entradas visuales compatibles, pero su modalidad de salida documentada es texto. Utilice un modelo de generación de imágenes cuando el resultado requerido sea una imagen en lugar de código, una explicación o texto estructurado.
P3. ¿Se puede utilizar toda la ventana de contexto de 1.049K para la entrada?
No. Los tokens de entrada y la salida solicitada deben caber dentro de la ventana de contexto. La guía de la API de SiliconFlow también recomienda dejar aproximadamente 10.000 tokens de margen en lugar de establecer max_tokens en el límite superior del modelo.
P4. ¿Cómo debe manejar una aplicación las respuestas HTTP 429, 503 o 504?
Reintente los fallos temporales con un retroceso exponencial limitado y aleatorización (jitter). Un HTTP 429 indica un límite de tarifa, mientras que las respuestas 503 o 504 pueden reflejar problemas temporales del servicio o de la pasarela. Limite los reintentos y registre los fallos persistentes para su investigación.