Límites de tarifa de la API de SiliconFlow y estrategias de reintento ante el error 429
Índice de contenidos
Los límites de velocidad de la API de LLM pueden pasar desapercibidos durante las pruebas porque el tráfico es pequeño y predecible. El tráfico de producción es diferente. Varios usuarios pueden enviar solicitudes al mismo tiempo, los prompts largos pueden consumir la capacidad de tokens rápidamente y los reintentos descontrolados pueden convertir un breve pico de tráfico en repetidos errores 429. En SiliconFlow, una integración de API estable requiere comprender RPM, TPM, límites específicos del modelo, concurrencia y errores temporales del servicio antes de que afecten a los usuarios.
¿Por qué las API de LLM tienen diferentes límites de velocidad?
El recuento de solicitudes por sí solo no representa los requisitos de procesamiento de una carga de trabajo de LLM.
Una solicitud de clasificación corta puede contener 200 tokens y devolver una etiqueta. Una solicitud de análisis de repositorio puede incluir miles de tokens de Input y generar una respuesta detallada. Ambas cuentan como una solicitud, pero su consumo de tokens, tiempo de procesamiento y requisitos de infraestructura difieren significativamente.
Múltiples límites de velocidad abordan diferentes patrones de tráfico:
Las solicitudes cortas y de alta frecuencia son más propensas a alcanzar los límites de solicitudes.
Los prompts largos y las ventanas de contexto grandes pueden alcanzar los límites de tokens con relativamente pocas solicitudes.
Los Outputs largos aumentan el consumo de tokens y mantienen las solicitudes activas durante más tiempo.
Los picos de tráfico pueden superar un límite incluso cuando el uso promedio parece aceptable.
Las cargas de trabajo masivas enviadas a través de endpoints en tiempo real pueden consumir capacidad en línea incluso cuando no requieren una respuesta inmediata.
SiliconFlow utiliza varias métricas de límite de velocidad, que incluyen RPM, RPH, RPD, TPM, TPD, IPM e IPD. Las aplicaciones de modelos de lenguaje principalmente necesitan monitorear RPM y TPM, aunque ciertos modelos o cuentas también pueden tener límites por hora o diarios. Una solicitud puede limitarse cuando cualquier métrica aplicable alcanza su máximo.
RPM frente a TPM: Comprensión de los límites de la API de SiliconFlow
RPM y TPM miden diferentes dimensiones del uso de la API.
Métrica | Significado | Cuello de botella común |
|---|---|---|
RPM | Solicitudes por minuto | Solicitudes pequeñas frecuentes |
TPM | Tokens por minuto | Prompts largos, contexto grande o Outputs largos |
RPH | Solicitudes por hora | Uso por hora específico del modelo |
RPD | Solicitudes por día | Volumen de solicitudes diario específico del modelo |
TPD | Tokens por día | Alto consumo diario de tokens |
¿Qué mide RPM?
RPM limita la cantidad de solicitudes que una cuenta puede enviar a un modelo dentro de un minuto.
Una aplicación puede alcanzar su límite de RPM incluso cuando cada solicitud contiene solo un prompt pequeño. Esto ocurre a menudo con herramientas de autocompletado, aplicaciones de Chat, bucles de agentes o flujos de trabajo que dividen una acción del usuario en varias llamadas al modelo.
Por ejemplo, la tarea de un agente puede requerir solicitudes separadas para la planificación, la selección de herramientas, la validación de resultados y la generación de la respuesta final. El usuario envía una tarea, pero la aplicación consume cuatro o más solicitudes.
¿Qué mide TPM?
TPM limita cuántos tokens puede procesar una aplicación dentro de un minuto.
Los prompts de sistema largos, el historial de conversación, los documentos recuperados, el código fuente, el contenido de razonamiento y los límites grandes de Output pueden aumentar el uso de tokens. Las aplicaciones deben monitorear los prompt_tokens, completion_tokens y total_tokens observados en lugar de estimar la capacidad solo a partir del recuento de solicitudes.
Considere dos aplicaciones que envían diez solicitudes por minuto cada una:
La aplicación A utiliza 300 tokens en total por solicitud.
La aplicación B utiliza 8,000 tokens en total por solicitud.
Ambas consumen 10 RPM. La aplicación A procesa aproximadamente 3,000 tokens, mientras que la aplicación B procesa aproximadamente 80,000. La aplicación B puede alcanzar su límite de TPM a pesar de que su volumen de solicitudes sigue siendo bajo.
Cómo aplica SiliconFlow los límites de velocidad
Los límites de velocidad de SiliconFlow se definen a nivel de cuenta de usuario en lugar de por separado para cada clave de API. Crear varias claves de API en una misma cuenta no genera capacidad independiente.
Los límites también se configuran por separado según el modelo. Alcanzar el límite para un modelo normalmente no impide que la cuenta llame a otro modelo con capacidad disponible. Los modelos gratuitos pueden tener límites fijos, mientras que los límites de los modelos de pago pueden variar según el nivel de la cuenta, la categoría del modelo y el tamaño del mismo. Consulte los detalles actuales del modelo antes de configurar el tráfico de producción.
¿Por qué su aplicación recibe errores 429?
Una respuesta HTTP 429 significa que se ha alcanzado un límite de velocidad aplicable. No siempre significa que la aplicación envió demasiadas solicitudes individuales.
Demasiadas solicitudes
Una ráfaga de llamadas pequeñas puede superar las RPM. Las aplicaciones de agentes son particularmente vulnerables porque una sola acción del usuario puede desencadenar varias solicitudes de API.
Demasiados tokens
Unas pocas solicitudes largas pueden superar el TPM. Las causas comunes incluyen prompts de sistema repetidos, historiales de conversación completos, resultados de recuperación de gran tamaño, archivos de código largos y límites de Output excesivos.
Múltiples servicios comparten el mismo límite
Varias aplicaciones, servicios backend, trabajadores o claves de API pueden usar la misma cuenta y modelo. Cada servicio puede parecer tener poco tráfico mientras que su uso combinado alcanza el límite a nivel de cuenta.
El tráfico llega en ráfagas
Una aplicación puede mantenerse por debajo de su capacidad promedio por hora pero seguir enviando demasiadas solicitudes o tokens en un período más corto. Por lo tanto, la profundidad de la cola y el uso por minuto son más útiles para diagnosticar errores 429 que los promedios diarios por sí solos.
Los reintentos automáticos aumentan la carga
Los reintentos inmediatos envían más tráfico a un sistema que ya está limitado. Cuando muchos trabajadores reintentan juntos, pueden crear una tormenta de reintentos que prolonga el problema original.
Se aplican límites específicos del modelo
Algunos modelos pueden tener restricciones adicionales por hora o diarias. No asuma que los límites mostrados para un modelo se aplican a todos los demás modelos disponibles a través de la API.
Una instancia dedicada está mal configurada
Las instancias dedicadas normalmente no utilizan los límites de velocidad estándar aplicados al acceso general de la API. Una respuesta 429 en esta configuración puede indicar que la aplicación está llamando al ID de modelo incorrecto o utilizando una clave de API que no coincide con la instancia dedicada.
El primer paso de diagnóstico es registrar el estado HTTP y el cuerpo completo de la respuesta. Las respuestas 429 de SiliconFlow incluyen un mensaje que puede ayudar a identificar si la falla fue causada por RPM, TPM, RPD, TPD, IPM o IPD.
Cómo distinguir los errores 429, 503 y 504
No todas las fallas temporales de la API son errores de límite de velocidad. La referencia de manejo de errores de SiliconFlow enumera los códigos de estado que devuelve la plataforma.
Código de estado | Causa típica | Respuesta recomendada |
|---|---|---|
429 | Se alcanzó un límite de velocidad aplicable | Reducir la velocidad de liberación de solicitudes y reintentar con un retraso progresivo |
503 | Carga temporal del servicio | Reintentar selectivamente o usar un modelo alternativo adecuado |
504 | Tiempo de espera de solicitud agotado o carga del servicio | Reintentar selectivamente, considerar el streaming y revisar la configuración del tiempo de espera |
400 | Parámetros incorrectos, incluido un ID de modelo no válido | Leer el mensaje de error y corregir los parámetros de la solicitud o el ID del modelo |
401 | Clave de API no válida o faltante | Corregir la autenticación |
403 | Permisos insuficientes | Comprobar el acceso a la cuenta y al modelo |
Es posible que los errores 504 repetidos en solicitudes largas que no son de streaming no se resuelvan enviando la misma solicitud nuevamente. Para cargas de trabajo de Chat, considere transmitir la respuesta por streaming, reducir el Output solicitado o revisar el tiempo de espera del cliente. La documentación de SiliconFlow también recomienda el streaming para las solicitudes de Chat y de texto a voz aplicables cuando ocurren errores 503 o 504.
Cómo manejar correctamente los límites de velocidad de la API de LLM
Una aplicación de producción debe reintentar solo fallas temporales y nunca debe reintentar indefinidamente.
Usar el retroceso exponencial (Exponential Backoff)
El retroceso exponencial aumenta el retraso después de cada intento fallido. Una secuencia de reintentos podría esperar aproximadamente un segundo, dos segundos, cuatro segundos y ocho segundos.
Establezca tanto un retraso máximo como un número máximo de intentos. Sin estos límites, una solicitud interactiva puede continuar mucho después de que sea útil para el usuario.
Añadir jitter (Variación aleatoria)
El jitter añade una pequeña variación aleatoria al retraso del reintento. Esto evita que varias instancias de la aplicación reintenten exactamente al mismo tiempo.
Sin jitter, las solicitudes que fallan juntas también pueden reintentarse juntas, provocando otro pico de tráfico.
Usar una cola de solicitudes
Una cola absorbe picos temporales y libera solicitudes a un ritmo controlado. Las solicitudes interactivas pueden recibir prioridad, mientras que los trabajos en segundo plano esperan la capacidad disponible.
Un limitador de velocidad de producción puede usar un diseño de algoritmo de cubo de tokens (token-bucket) o cubo con goteo (leaky-bucket) para controlar la rapidez con la que se liberan las nuevas solicitudes. Esto es diferente de limitar solo el número de solicitudes actualmente en curso.
Establecer un límite máximo de reintentos
De tres a cinco intentos pueden ser razonables para algunas aplicaciones interactivas, pero el número correcto depende del tiempo de espera de la solicitud, la experiencia del usuario y la importancia comercial.
Después del último intento, devuelva un error claro, guarde la tarea para su procesamiento posterior o diríjala a un modelo alternativo aprobado.
No repetir efectos secundarios externos
Los flujos de trabajo de los agentes pueden llamar a sistemas de pago, bases de datos, operaciones de archivos u otras herramientas externas. Reintentar la solicitud del modelo no debería repetir automáticamente una acción que ya se realizó correctamente.
Utilice claves de idempotencia, ID de operación u otro mecanismo de deduplicación para proteger las acciones posteriores.
Usar una única capa de reintento
Algunos SDK, incluida la biblioteca de Python de OpenAI utilizada anteriormente, incluyen reintentos automáticos. Añadir otro bucle de reintento a nivel de aplicación puede multiplicar el número total de intentos.
El siguiente ejemplo de Python desactiva los reintentos a nivel de SDK e implementa una única política de reintento acotada con retroceso exponencial y jitter, y respeta la cabecera Retry-After cuando el servidor proporciona una:
SiliconFlow admite llamadas compatibles con OpenAI a través de la URL base https://api.siliconflow.com/v1. Los desarrolladores pueden añadir lógica de reintento, colas, monitoreo y enrutamiento de modelos manteniendo un flujo de trabajo de SDK familiar.
Cómo calcular un límite seguro de concurrencia de la API
RPM y TPM miden el rendimiento. La concurrencia mide cuántas solicitudes están activas al mismo tiempo. Los valores están relacionados, pero no son intercambiables.
Utilice los datos de producción observados para estimar un punto de partida:
Suponga que un modelo tiene:
1,200 RPM
60,000 TPM
1,200 tokens totales observados por solicitud
Un tiempo de respuesta P95 de cuatro segundos
Un factor de seguridad del 80%
La tasa basada en RPM es:
La tasa basada en TPM es:
El TPM es la restricción más estricta. Después de aplicar el factor de seguridad:
La concurrencia activa estimada es:
La aplicación podría comenzar con un límite de concurrencia de dos o tres solicitudes activas y ajustarlo utilizando datos de producción.
Esta es una estimación de planificación de capacidad, no un límite de API garantizado. El uso de tokens y la latencia varían según el prompt, el modelo, la longitud del Output y el patrón de tráfico. Un límite de concurrencia tampoco impone RPM o TPM por sí mismo. Utilícelo con un limitador de velocidad basado en colas, algoritmo de cubo de tokens o cubo con goteo que controle cuándo se liberan las nuevas solicitudes.
Cómo diseñar una aplicación en torno a los límites de velocidad
El manejo de los límites de velocidad debe ser parte de la arquitectura de la aplicación en lugar de una excepción añadida después del lanzamiento.
Estimar solicitudes por acción del usuario
Mida cuántas llamadas al modelo crea una única acción del usuario. Los flujos de trabajo de agentes pueden generar varias solicitudes de API incluso cuando la interfaz muestra solo un mensaje del usuario.
Monitorear la distribución de tokens
El uso promedio de tokens puede ocultar prompts inusualmente grandes. Realice un seguimiento de los valores de mediana, P95 y máximos para el prompt, la completación y los tokens totales.
Controlar el tráfico por modelo
Dado que los modelos tienen límites separados, los modelos de uso intensivo pueden necesitar sus propias colas, límites de concurrencia y monitoreo. Un límite global único puede subutilizar la capacidad disponible o permitir que una carga de trabajo domine la aplicación.
Establecer límites para prompts y outputs
Elimine el contexto duplicado, limite los resultados de recuperación, resuma el historial de conversación más antiguo y utilice límites de Output realistas. Estos cambios reducen la presión de TPM y el coste de inferencia al mismo tiempo.
Dirigir las cargas de trabajo a modelos adecuados
SiliconFlow proporciona acceso a una amplia gama de modelos de lenguaje y Multimodales a través de una API unificada. Las aplicaciones pueden enrutar cargas de trabajo de clasificación, extracción, razonamiento, codificación y tareas multimodales de acuerdo con los requisitos de calidad, latencia, coste y capacidad.
El enrutamiento del modelo debe reflejar los requisitos de la tarea en lugar de servir como una forma de evitar los límites de la plataforma. Cada ruta requiere monitoreo de calidad, latencia, tokens y fallas.
Mover trabajos sin conexión a la API por lotes (Batch API)
Las evaluaciones, el procesamiento de documentos, la clasificación y los grandes trabajos de extracción no siempre necesitan respuestas en tiempo real.
Cuando esté disponible, la Batch API de SiliconFlow puede ser adecuada para cargas de trabajo elegibles sin conexión. Confirme los modelos, endpoints, comportamiento de procesamiento y límites aplicables actualmente admitidos antes de la implementación.
Solicitar límites de RPM o TPM más altos
La optimización de prompts, las colas y los controles de reintento pueden gestionar picos temporales de tráfico, pero no pueden resolver un desajuste de capacidad permanente.
Cuando el tráfico de producción normal se acerque de forma constante al límite de RPM o TPM disponible, abra el Model Plaza, seleccione Higher Limits en la parte inferior de la barra lateral izquierda y envíe el formulario de Solicitud de aumento de RPM y TPM de SiliconFlow.
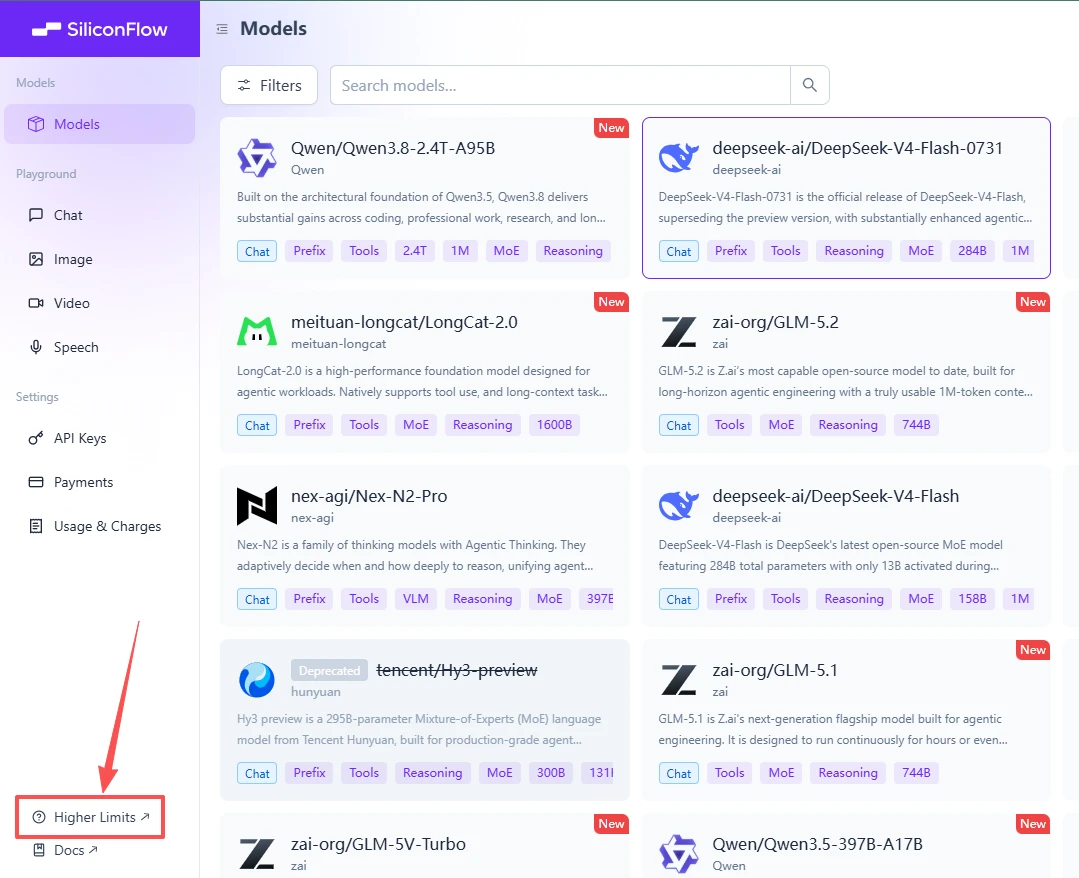
Incluya estimaciones de tráfico realistas, consumo de tokens esperado, patrones de carga de trabajo y requisitos de producción. El envío del formulario inicia una evaluación y no garantiza que se apruebe cada límite solicitado.
Evaluar capacidad dedicada
Las aplicaciones con un rendimiento alto y sostenido o con la necesidad de una capacidad más predecible también pueden evaluar una instancia dedicada.
Las instancias dedicadas normalmente no utilizan los límites de velocidad de la cuenta estándar aplicados al acceso general de modelos. Aún así, se deben monitorear para comprobar el rendimiento de la instancia, la latencia, los tiempos de espera agotados, la profundidad de la cola y los límites en otras partes de la infraestructura de la aplicación.
Preguntas frecuentes sobre los límites de velocidad de la API de LLM
P1: ¿Qué significa TPM en una API de LLM?
TPM significa tokens por minuto. Mide cuántos tokens puede procesar una aplicación en un minuto. Los prompts largos, el historial de conversación, los documentos recuperados, el contenido de razonamiento y los Outputs largos pueden alcanzar el TPM antes de que la aplicación alcance su límite de RPM.
P2: ¿Por qué recibo un error 429 con un volumen de solicitudes bajo?
Unas pocas solicitudes de contexto largo pueden consumir una gran cantidad de tokens. El tráfico en ráfagas, el uso de cuentas compartidas, los reintentos automáticos o los límites horarios y diarios específicos del modelo también pueden producir una respuesta 429 incluso cuando el volumen total de solicitudes parece bajo.
P3: ¿Debería reintentar cada solicitud de API de LLM fallida?
No. Reintente fallas temporales como errores 429, errores 503 o 504 seleccionados, fallas de conexión y tiempos de espera agotados con un retroceso progresivo acotado. Un error 400 generalmente indica parámetros no válidos o un ID de modelo incorrecto, mientras que 401 apunta a una clave de API no válida, 403 indica permisos insuficientes y 404 puede indicar un endpoint o ruta de recurso incorrecta. Estos problemas deben corregirse antes de volver a enviar la solicitud.
P4: ¿El aumento de RPM también aumenta el TPM?
No automáticamente. RPM y TPM miden diferentes restricciones. Los límites disponibles pueden variar según el modelo, el nivel de la cuenta, el tamaño del modelo y el tipo de implementación. Consulte los detalles actuales del modelo antes de configurar la capacidad de producción.
P5: ¿Cómo puedo reducir los errores de límite de velocidad de la API de LLM?
Acorte el contexto innecesario, controle las tasas de liberación de solicitudes, limite la concurrencia, use reintentos acotados con jitter y monitoree el uso de tokens. Mueva los trabajos sin conexión elegibles a la API por lotes y solicite límites más altos cuando la demanda de producción sostenida se acerque a las RPM o TPM disponibles.