¿Necesitas un reranker para RAG? Embeddings, reranking y recuperación en dos etapas explicados
Índice de contenidos
No todas las aplicaciones de RAG necesitan un reranker. Resulta útil cuando el sistema de recuperación encuentra habitualmente pruebas relevantes, pero no posiciona los mejores fragmentos lo suficientemente arriba. Los modelos de Embedding admiten una recuperación eficiente de candidatos en grandes colecciones de documentos, mientras que los modelos de reranking comparan la consulta con dichos candidatos con mayor detalle. SiliconFlow proporciona las API tanto de Embedding como de Rerank, lo que permite a los desarrolladores compilar, probar y optimizar una canalización de recuperación en dos etapas a través de una única plataforma de API de modelos.
¿Por qué la búsqueda vectorial a veces no encuentra el mejor contexto para RAG?
La búsqueda vectorial es una base práctica para la generación aumentada por recuperación porque puede comparar una consulta con una gran colección de vectores de documentos precalculados. Sin embargo, los fragmentos con las puntuaciones de similitud más altas no siempre son los fragmentos más útiles para responder a la pregunta del usuario.
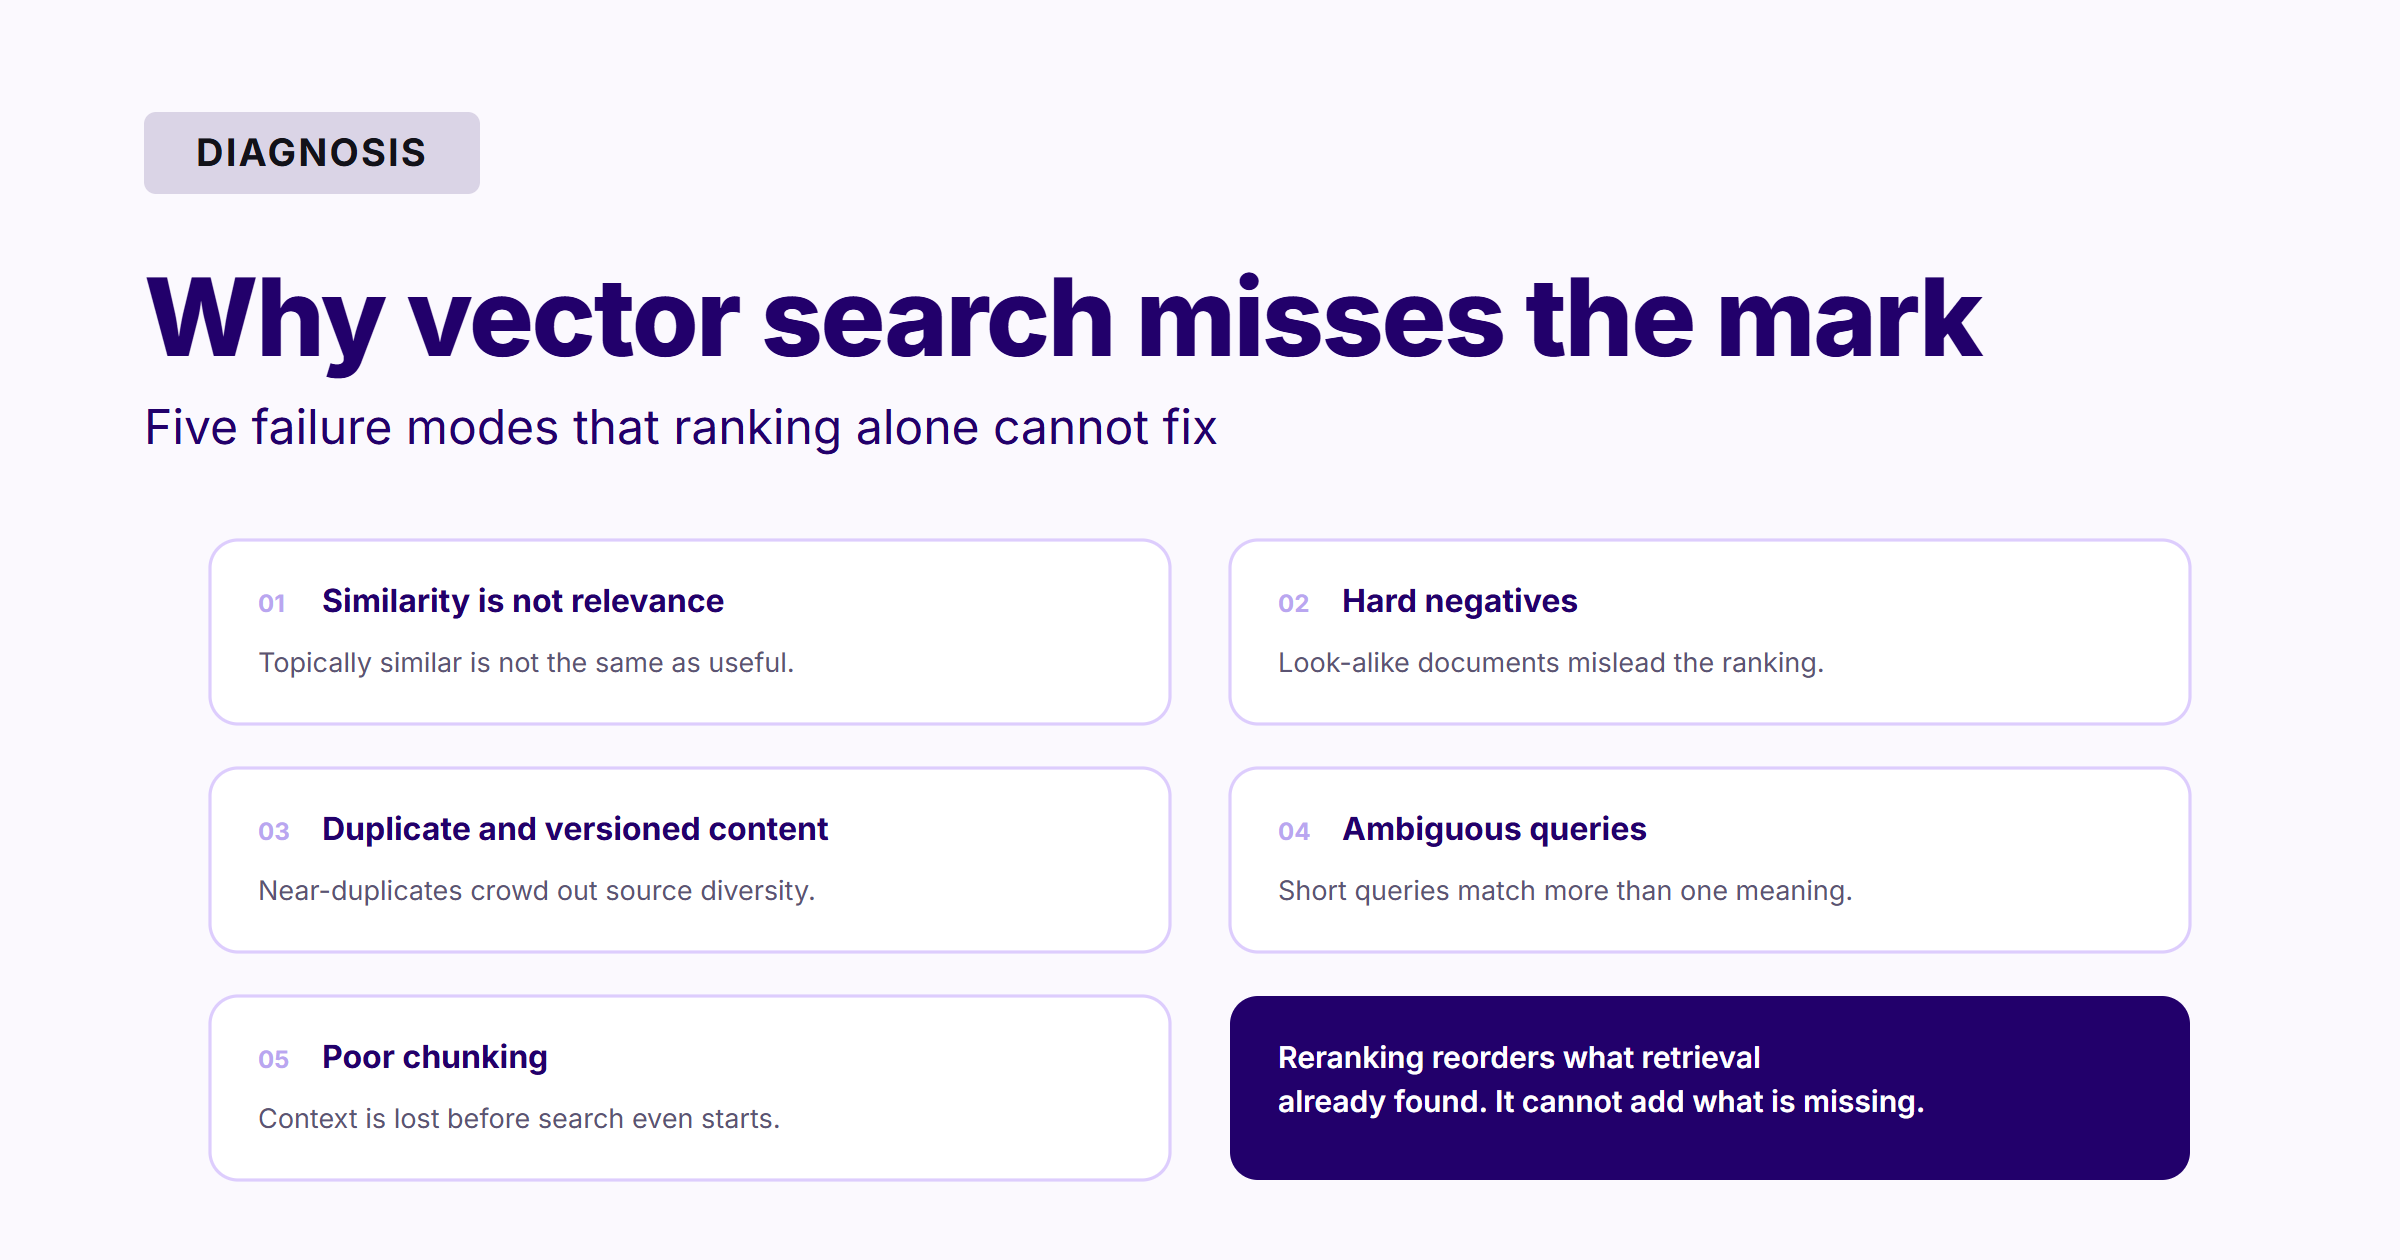
La similitud semántica no siempre equivale a la relevancia de la respuesta
Un modelo de embedding puede identificar dos fragmentos como semánticamente similares porque tratan el mismo tema. Eso no significa que ambos fragmentos satisfagan la intención exacta del usuario.
Por ejemplo, una consulta sobre cómo aumentar el límite de velocidad de una API podría recuperar:
Una definición general de los límites de velocidad
Una página de precios que menciona el uso
Una guía de resolución de problemas para errores HTTP 429
El procedimiento específico para solicitar un límite superior
Los cuatro fragmentos están relacionados con la consulta, pero es posible que solo uno contenga la acción requerida. Un reranker puede comparar la consulta completa con cada candidato recuperado y situar el fragmento más útil más cerca de la parte superior.
Las colecciones grandes contienen más negativos difíciles
Una base de conocimiento grande no requiere automáticamente un reranking. Sin embargo, las colecciones más grandes a menudo contienen más negativos difíciles: documentos que parecen muy relevantes pero que no aportan las pruebas necesarias para responder a la pregunta.
Esto es común en colecciones que contienen:
Múltiples versiones de la documentación de la API
Especificaciones de producto similares
Artículos de soporte repetidos
Variaciones regionales de la misma directiva
Documentos archivados y actuales
Páginas que reutilizan terminología técnica similar
Estos fragmentos pueden aparecer muy juntos en un espacio de embedding. Un reranker añade una segunda señal de relevancia que puede distinguir entre un contenido ampliamente similar y un contenido que satisface directamente la consulta.
El contenido duplicado y con versiones puede entrar en conflicto
Los documentos casi duplicados pueden ocupar varias posiciones en los resultados iniciales de recuperación. Esto puede reducir la diversidad de las fuentes y permitir que la información desactualizada compita con una versión más reciente.
El reranking puede mejorar su orden, pero no reemplaza la gestión documental. Los metadatos de versión, las fechas de publicación, los permisos de acceso, la eliminación de duplicados y las reglas de archivado deben seguir gestionándose durante la ingesta o la recuperación.
Las consultas ambiguas pueden coincidir con múltiples significados
Las consultas cortas, las abreviaturas, los nombres de productos y los términos técnicos pueden tener varias interpretaciones. La búsqueda por embedding puede recuperar documentos asociados a más de un significado, especialmente cuando la consulta carece de contexto.
Un reranker puede mejorar el orden cuando el significado previsto queda claro a partir de la consulta completa o de la conversación. Cuando falta información esencial, aún puede ser necesaria la reescritura de consultas, el filtrado por metadatos, el historial de conversación o la aclaración del usuario.
La división deficiente en fragmentos no se puede solucionar únicamente mediante la clasificación
Algunos problemas de recuperación comienzan antes de la búsqueda vectorial. Los documentos de origen pueden dividirse en fragmentos demasiado cortos, demasiado largos o desconectados de sus encabezados y del contexto circundante.
Por ejemplo:
Una tabla puede quedar separada de las etiquetas de sus columnas.
Un límite de API puede quedar separado del modelo al que se aplica.
Un procedimiento puede quedar dividido respecto a una advertencia importante.
Un encabezado puede almacenarse por separado del párrafo que describe.
Un reranker solo puede reordenar los candidatos que recibe. No puede reconstruir el contexto faltante ni recuperar un fragmento relevante que el recuperador de primera etapa no haya devuelto.
Modelo de Embedding frente a modelo de reranking
Los modelos de embedding y de reranking desempeñan funciones complementarias en una canalización de RAG. No son alternativas intercambiables.
Característica | Modelo de Embedding | Modelo de reranking |
|---|---|---|
Objetivo principal | Recuperación de candidatos | Ordenación de candidatos |
Input típico | Contenido de la consulta o del documento | Consulta y documentos candidatos |
Output | Vectores de embedding densos | Puntuaciones de relevancia y resultados clasificados |
Patrón de procesamiento | Las consultas y los documentos se codifican por separado | La consulta se evalúa en relación con los candidatos recuperados |
Etapa típica | Recuperación de primera etapa | Clasificación de segunda etapa |
Ventaja principal | Búsqueda escalable en grandes colecciones | Comparación de relevancia más precisa |
Principal contrapartida | Los fragmentos similares pueden superar a los más útiles | Añade otro paso de inferencia |
Un modelo de embedding convierte fragmentos de documentos en vectores que pueden almacenarse en una base de datos vectorial. En el momento de la consulta, el mismo tipo de modelo convierte la consulta en un vector y la base de datos recupera los candidatos cercanos.
Esta arquitectura escala porque los embeddings de los documentos se pueden generar antes de que los usuarios envíen sus consultas. El sistema no necesita comparar cada consulta directamente con cada documento de origen.
Un modelo de reranking opera después de la recuperación de candidatos. Recibe la consulta original y un conjunto limitado de documentos candidatos y, a continuación, genera una puntuación de relevancia o un orden revisado para cada resultado.
La serie Qwen3 Embedding incluye modelos independientes de embedding y de reranking en tamaños de 0.6B, 4B y 8B. Estas opciones están diseñadas para admitir diferentes requisitos de eficiencia y eficacia.
Las dos etapas responden a preguntas diferentes:
Modelo de embedding: ¿Qué documentos podrían ser relevantes?
Modelo de reranking: ¿Cuáles de esos candidatos satisfacen mejor esta consulta?
Por lo tanto, un reranker normalmente no reemplaza a los embeddings en un sistema RAG grande. Los embeddings reducen primero el espacio de búsqueda, mientras que el reranker aplica una evaluación de relevancia más detallada a un conjunto manejable de candidatos.
¿Cuándo necesita un reranker para RAG?
La decisión debe basarse en la evaluación de la recuperación y no solo en el tamaño de la base de conocimiento.
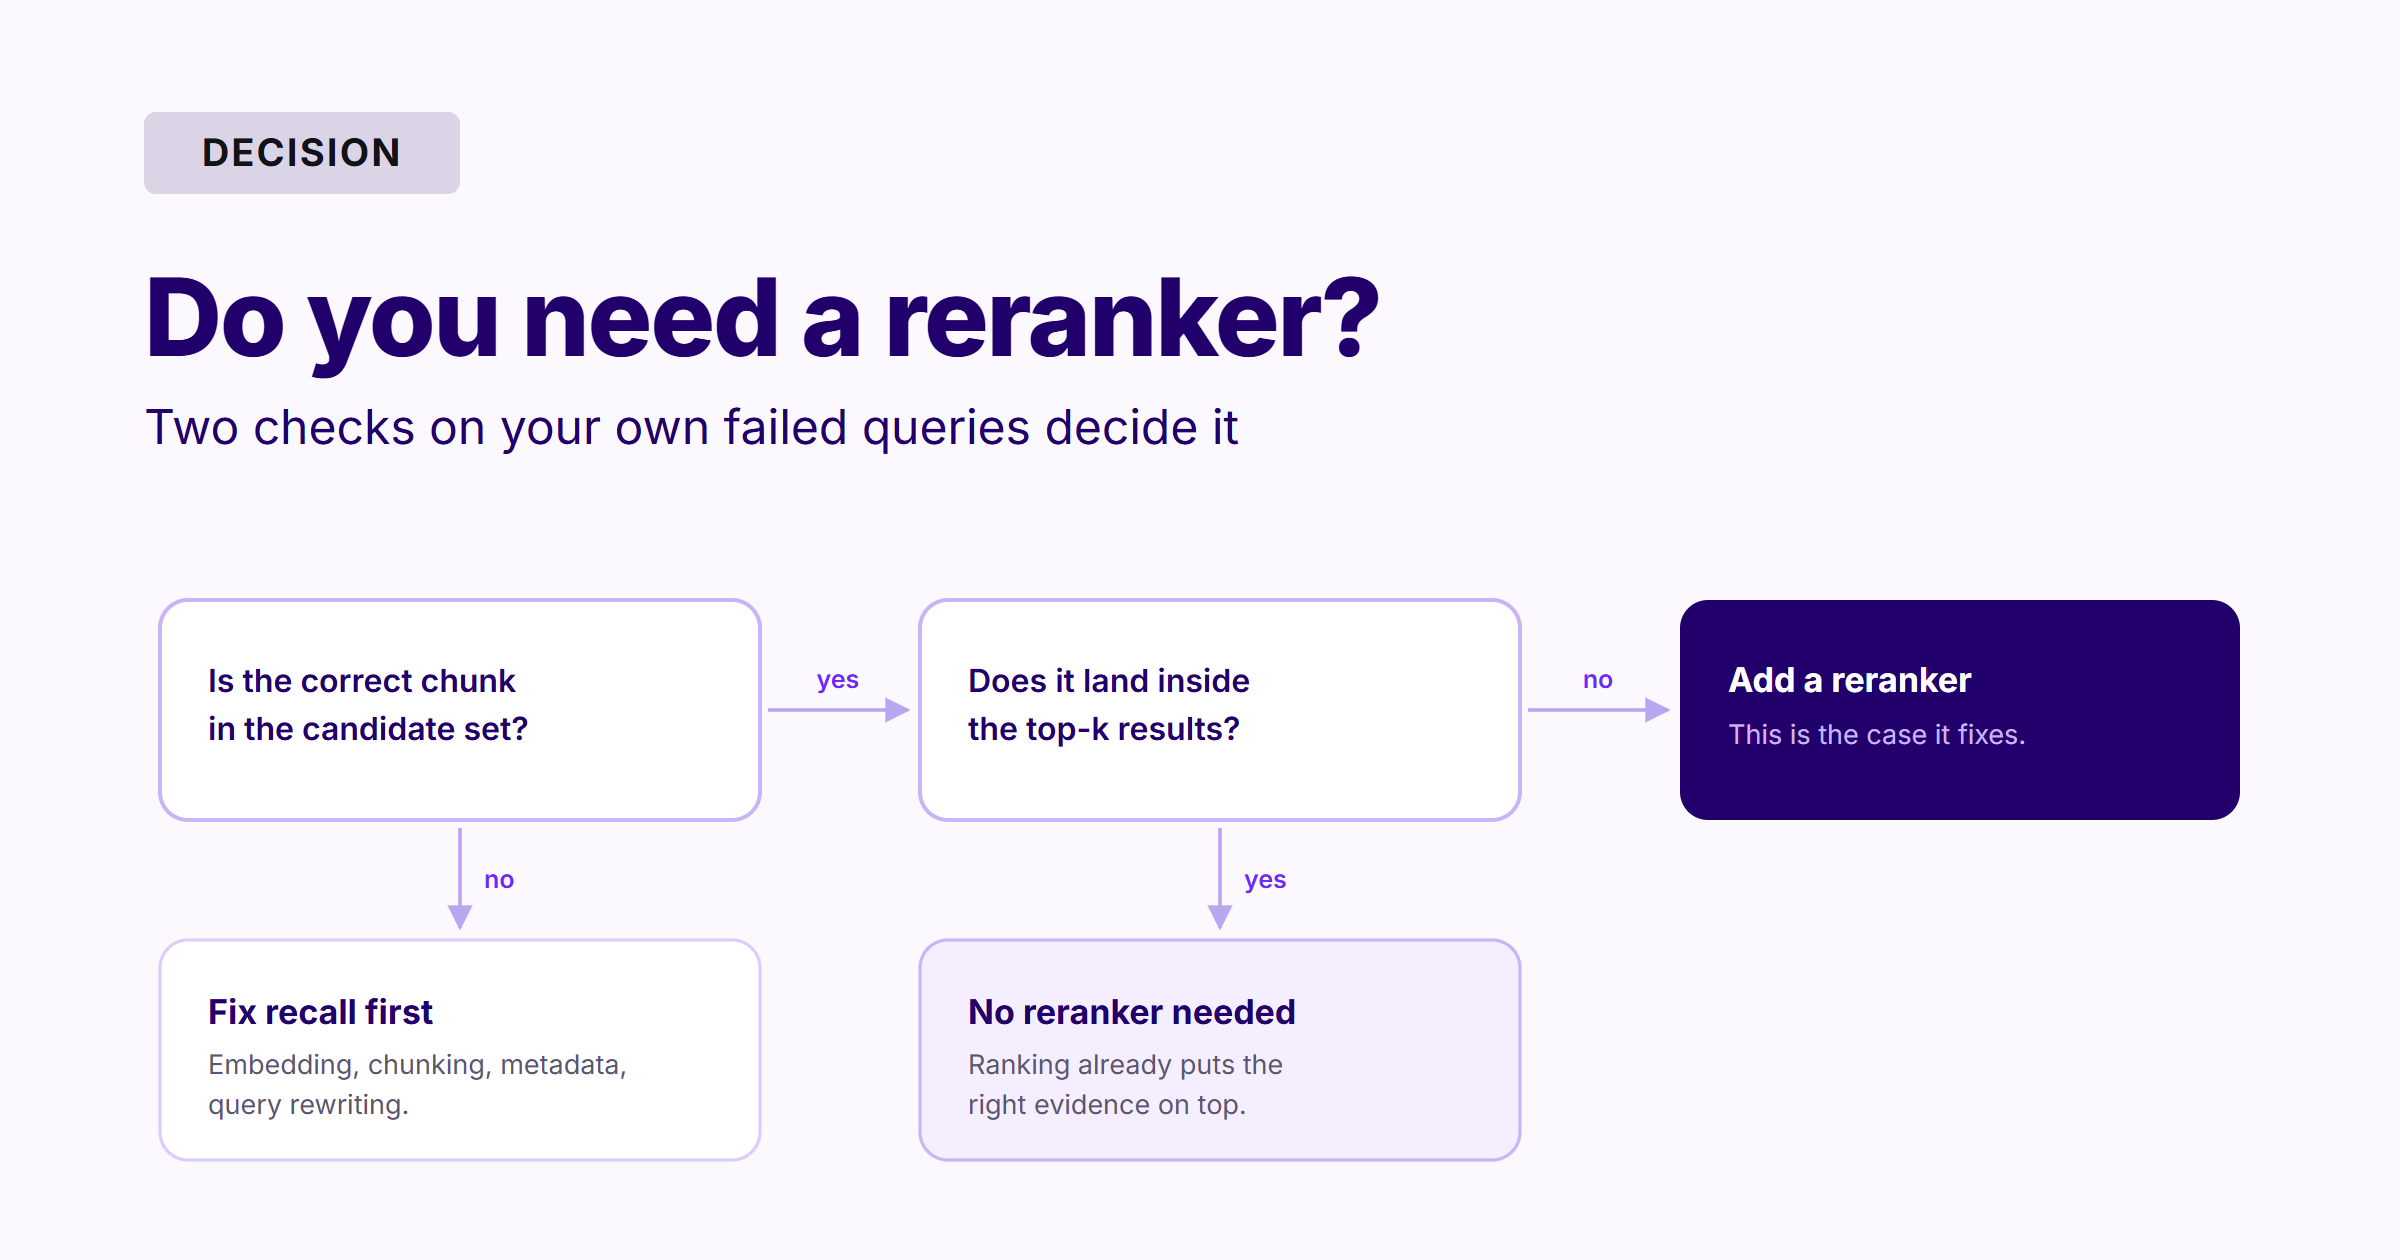
El fragmento correcto se recupera pero se clasifica demasiado abajo
Una de las señales más claras es que el fragmento correcto aparece con frecuencia en el conjunto inicial de candidatos pero no llega al contexto final.
Por ejemplo, el fragmento relevante puede aparecer periódicamente entre los 20 mejores resultados pero rara vez entra en los tres primeros. El modelo de generación recibe entonces fragmentos menos útiles, a pesar de que el sistema de recuperación encontró técnicamente la información requerida.
Este es principalmente un problema de clasificación, lo que lo convierte en un claro caso de uso para un reranker.
Las consultas incluyen varias condiciones
Una similitud semántica amplia puede ser insuficiente cuando una consulta contiene varias restricciones.
Algunos ejemplos incluyen:
Comparar dos productos bajo un presupuesto específico
Encontrar una configuración de API para un modelo y una región específicos
Identificar una directiva que se aplique después de una fecha concreta
Solucionar un error bajo una configuración específica
Recuperar pruebas que deben satisfacer varias condiciones técnicas
Un reranker puede evaluar la consulta completa con respecto a cada candidato en lugar de confiar únicamente en la proximidad vectorial.
Los documentos recuperados son muy similares
Los catálogos de productos, la documentación de API, las bases de conocimiento internas, las directivas legales y las colecciones de investigación a menudo contienen fragmentos con un lenguaje superpuesto.
El reranking puede ayudar cuando los resultados iniciales son temáticamente correctos pero difieren en detalles como:
Versión del producto o modelo
Fecha de publicación
Región
Entorno de software
Tipo de usuario
Configuración
Condiciones de idoneidad
Solo se puede enviar una pequeña cantidad de contexto al LLM
Un sistema de recuperación puede devolver muchos fragmentos potencialmente relevantes, pero el modelo de generación no siempre debe recibirlos todos.
Demasiado contexto puede:
Aumentar el uso de input tokens
Añadir información duplicada
Introducir versiones contradictorias
Distraer al modelo de las pruebas más sólidas
Aumentar la latencia de generación
Un reranker puede ayudar a seleccionar un conjunto de contexto más reducido y con una señal más alta a partir de un grupo más amplio de candidatos.
La precisión de la recuperación tiene un gran valor empresarial
El soporte técnico, la búsqueda empresarial, los flujos de trabajo de cumplimiento, la investigación financiera y otras aplicaciones sensibles a la precisión pueden beneficiarse de una selección de pruebas más precisa.
El paso adicional de inferencia puede estar justificado cuando seleccionar el fragmento incorrecto puede generar una respuesta engañosa, provocar correcciones repetidas o reducir la confianza del usuario.
La recuperación de primera etapa ya funciona bien
Un reranker puede aportar poco valor cuantificable cuando:
La base de conocimiento es pequeña y está claramente estructurada.
La respuesta correcta aparece sistemáticamente cerca de la parte superior.
Los filtros de metadatos ya separan los documentos similares.
Las consultas coinciden estrechamente con las preguntas frecuentes almacenadas.
La coincidencia exacta o la búsqueda híbrida gestionan la carga de trabajo.
La aplicación tiene un presupuesto de latencia sumamente estricto.
La evaluación sin conexión no muestra ninguna mejora significativa.
Añadir un reranker sin ganancias cuantificables incrementa la complejidad del sistema sin mejorar necesariamente la experiencia del usuario.
¿Qué no puede solucionar un reranker?
El reranking es una parte de la optimización de la recuperación en RAG. No puede solucionar directamente:
Documentos ausentes o no indexados
Permisos de documentos incorrectos
Material de origen desactualizado
Extracción de Text u OCR defectuosos
Límites de fragmentos deficientes
Filtros de metadatos incorrectos
Un conjunto incompleto de candidatos de primera etapa
Consultas que omiten detalles esenciales
Respuestas que no existen en la base de conocimiento
Antes de añadir un reranker, inspeccione las consultas fallidas y determine si realmente se recuperaron las pruebas correctas.
Cuando el fragmento correcto falta en un conjunto de candidatos razonablemente amplio, céntrese primero en el modelo de embedding, la estrategia de fragmentación, los metadatos, la transformación de consultas, la recuperación híbrida o la configuración del índice.
Cuando el fragmento correcto está presente pero clasificado por debajo de resultados más débiles, es más probable que el reranking ayude.
Cómo funciona la recuperación en dos etapas con las API de SiliconFlow
Una arquitectura de recuperación en dos etapas separa el descubrimiento amplio de candidatos de la clasificación detallada de relevancia.

La primera etapa echa una red amplia; la segunda decide qué lee realmente el modelo.
Etapa 1: Generar y almacenar embeddings de documentos
Durante la ingesta, divida los documentos de origen en fragmentos significativos y envíe el text a la API de Embedding de SiliconFlow:
La API convierte el input text en vectores de embedding. La documentación internacional actual de la API incluye Qwen/Qwen3-Embedding-8B, junto con las variantes 0.6B y 4B. Los modelos Qwen3 también admiten dimensiones de output configurables, que deben ser coherentes con el índice vectorial de destino.
Una solicitud simplificada en Python se ve así:
Almacene cada vector junto con el text original, el identificador del documento, la URL de origen, la versión, la información de acceso y otros metadatos útiles.
Etapa 2: Recuperar un conjunto de candidatos
Cuando un usuario envía una consulta:
Genere un embedding para la consulta.
Busque en la base de datos vectorial.
Devuelva un conjunto de candidatos para el reranking.
La primera etapa debe priorizar el recuerdo (recall). Su función es garantizar que las pruebas relevantes entren en el conjunto de candidatos, no necesariamente producir el orden final.
La profundidad adecuada de candidatos depende del conjunto de datos y del presupuesto de latencia. Recuperar muy pocos fragmentos limita lo que el reranker puede seleccionar. Recuperar demasiados incrementa el tamaño del input de reranking y el tiempo de procesamiento.
No existe un número universal de candidatos que funcione para todos los sistemas RAG.
Etapa 3: Reclasificar los candidatos (rerank)
Envíe la consulta original y las cadenas de documentos recuperadas a la API de Rerank de SiliconFlow:
La API internacional actual acepta una consulta, un array de cadenas de documentos y campos opcionales como top_n y return_documents. Los resultados incluyen el índice del candidato original y una puntuación de relevancia, lo que permite a la aplicación volver a conectar cada resultado con sus datos de origen almacenados.
La disponibilidad de los modelos puede variar con el tiempo. Mantenga los ID de modelo en la configuración en lugar de codificarlos en el código de la aplicación y verifique la disponibilidad actual antes de pasar a producción.
Etapa 4: Construir el contexto final
Tras el reranking, seleccione los fragmentos mejor clasificados que se ajusten al presupuesto de contexto de la aplicación.
El paso final de creación del contexto también puede aplicar:
Eliminación de duplicados
Reglas de diversidad de fuentes
Límites de tokens
Comprobaciones de versión o fecha
Validación del control de acceso
Formato de citas
Agrupación a nivel de documento
Evite considerar un único umbral de puntuación de relevancia como válido universalmente. Las distribuciones de puntuaciones pueden variar según el modelo, el conjunto de datos y el tipo de consulta. Los umbrales deben calibrarse utilizando consultas representativas.
A continuación, el contexto final puede enviarse a un modelo de generación a través de la API de Chat Completions de SiliconFlow, creando un flujo de trabajo completo de recuperación, reranking y generación mediante la misma plataforma de infraestructura de IA.
Cómo medir si el reranking mejora su sistema RAG
Compare una base de referencia basada únicamente en embedding con una canalización en dos etapas utilizando las mismas consultas de evaluación. No juzgue el reranker a partir de unos pocos ejemplos seleccionados a mano.
Medir el recuerdo (recall) de la primera etapa
Primero confirme que el recuperador inicial suministra candidatos útiles.
Las métricas habituales incluyen:
Recall@k: Cuántas de las pruebas relevantes aparecen dentro de los primeros k candidatos
Hit Rate@k: Con qué frecuencia aparece al menos un fragmento relevante dentro de los primeros k candidatos
Si el recuerdo de la primera etapa es deficiente, el reranking no podrá compensar las pruebas ausentes.
Medir la calidad de la clasificación
Las métricas de clasificación muestran si el reranker mueve las pruebas útiles más cerca de la parte superior.
Entre las métricas útiles se incluyen:
Precision@k: La proporción de los primeros k resultados que son relevantes
Mean Reciprocal Rank: Qué tan arriba aparece el primer resultado relevante
nDCG@k: Si los documentos más relevantes se clasifican por encima de los menos relevantes
Recall@k tras el reranking: Si el conjunto final más reducido de resultados conserva las pruebas requeridas
Elija métricas que coincidan con la aplicación. Un asistente de soporte puede necesitar un fragmento correcto cerca de la parte superior, mientras que un flujo de trabajo de investigación puede requerir varias fuentes complementarias.
Evaluar la respuesta final
Una clasificación mejorada solo tiene valor cuando mejora la aplicación RAG completa.
Mida:
Corrección de la respuesta
Relevancia de la respuesta
Fidelidad al contexto recuperado
Tasa de afirmaciones sin fundamento
Precisión de las citas
Tasa de finalización de tareas
Frecuencia de correcciones por parte del usuario
El conjunto de evaluación debe incluir consultas habituales, consultas difíciles, redacciones ambiguas, preguntas sensibles a las versiones y casos de alto riesgo.
Medir la eficiencia del contexto
Haga un seguimiento de si el reranking ayuda a la aplicación a utilizar su ventana de contexto de manera más eficaz:
Número de candidatos iniciales
Número de resultados reclasificados retenidos
Tokens de contexto final
Tasa de contexto duplicado
Pruebas relevantes por ventana de contexto
El reranking no reduce automáticamente la longitud del contexto. El ahorro de tokens se produce solo cuando la aplicación utiliza la nueva clasificación para descartar los fragmentos de bajo valor.
Medir la latencia y el coste
El reranking añade otro paso de inferencia, por lo que debe realizar un seguimiento de:
Latencia del reranker
Latencia integral (end-to-end)
Latencia p50 y p95
Input tokens del reranker
Input tokens de generación
Coste por consulta completada
Tasas de error y de tiempo de espera (timeout)
Un reranker puede incrementar la latencia de la etapa de recuperación a la vez que reduce la cantidad de contexto procesado durante la generación. Evalúe la ruta completa de la solicitud en lugar de solo la llamada al reranker.
Pruebe varias combinaciones de profundidad de candidatos y top_n. La mejor configuración es aquella que cumple los objetivos de recuperación y calidad de respuesta de la aplicación dentro de sus límites de latencia y coste.
Preguntas frecuentes
¿Es necesario un reranker para todas las aplicaciones RAG?
No. Las bases de conocimiento pequeñas o claramente estructuradas pueden funcionar bien solo con búsqueda por embedding, filtrado por metadatos, coincidencia de palabras clave o recuperación híbrida. Añada un reranker cuando las pruebas demuestren que se recuperan candidatos útiles pero que no se clasifican consistentemente lo suficientemente arriba.
¿Un reranker reemplaza a los embeddings?
No. Los modelos de embedding recuperan candidatos de forma eficiente a partir de una gran colección. Los modelos de reranking refinan el orden de un conjunto de candidatos más reducido. Ambos tipos de modelo desempeñan funciones complementarias en una arquitectura típica de recuperación en dos etapas.
¿El reranking incrementa la latencia en RAG?
Normalmente sí. El reranking introduce otro paso de inferencia. Sin embargo, una mejor clasificación puede permitir que el sistema envíe menos fragmentos de bajo valor al modelo de generación. Mida la latencia total integral (end-to-end) en lugar de evaluar la llamada al reranker de forma aislada.
¿Cuántos documentos debería enviar a un reranker?
No hay un número universal. El conjunto de candidatos debe ser lo suficientemente grande como para mantener el recuerdo de la primera etapa, pero lo bastante reducido como para cumplir los requisitos de latencia y coste. Pruebe varias profundidades de candidatos en consultas representativas y compare la calidad de recuperación, la calidad de respuesta, el uso de tokens y el tiempo de respuesta.
¿Puede SiliconFlow proporcionar API tanto de Embedding como de Reranking?
Sí. SiliconFlow proporciona una API de Embedding para generar vectores y una API de Rerank para puntuar la relevancia entre consultas y documentos. Los desarrolladores pueden combinarlas en una canalización de recuperación en dos etapas y enviar el contexto seleccionado a un modelo de generación a través de la misma plataforma.
Diseñe el reranking en torno a problemas de recuperación medidos
Un reranker es más valioso cuando la recuperación de primera etapa encuentra pruebas relevantes pero no las clasifica de forma fiable. Antes de añadir uno, confirme que los fragmentos correctos entren en el conjunto de candidatos y compare una base de referencia basada solo en embedding con una canalización en dos etapas. Con las API de Embedding y Rerank de SiliconFlow, los desarrolladores pueden probar ambos enfoques, ajustar la profundidad de los candidatos y el tamaño del contexto final, y elegir una configuración que satisfaga los requisitos de precisión, latencia y coste de su aplicación.