Cómo utilizar una API de generación de Video con IA: enviar tareas, consultar el estado y almacenar resultados
Índice de contenidos
Una API de generación de Video normalmente no devuelve un archivo terminado en la respuesta inicial. La inferencia de Video lleva más tiempo que la generación de Text y puede requerir recursos de computación en cola antes de que comience el procesamiento. Con SiliconFlow, su aplicación envía una solicitud de generación, recibe un requestId, comprueba el estado de la tarea y descarga el resultado cuando la generación tiene éxito. Este flujo de trabajo asíncrono admite aplicaciones de text-to-video e image-to-video sin necesidad de que usted despliegue o mantenga los modelos subyacentes de Video.
¿Por qué las API de Video con IA suelen ser asíncronas?
A menudo, una respuesta de Text se puede generar dentro de una única solicitud HTTP. La generación de Video implica un mayor cómputo y produce un Output mucho mayor, por lo que mantener la conexión original abierta hasta que finalice es menos fiable.
Una conexión de larga duración puede verse interrumpida por:
Tiempos de espera (timeouts) del cliente o de la pasarela
Fallos temporales de red
Tiempos variables de cola y de procesamiento
Reinicios de la aplicación
Transferencias de resultados de gran tamaño
Una API asíncrona de generación de Video separa el envío del trabajo de la recuperación del resultado. Su aplicación envía la solicitud primero, almacena el identificador devuelto y comprueba el resultado a través de un endpoint independiente.
Este enfoque permite que una solicitud web finalice rápidamente mientras un proceso trabajador supervisa el trabajo de Video de forma independiente. También facilita la recuperación de tareas interrumpidas sin tener que volver a enviar la misma solicitud de generación.
¿Cómo funciona el flujo de trabajo de la API de generación de Video de SiliconFlow?
Utilice estos valores exactos y su correspondiente uso de mayúsculas en la lógica de su aplicación.
4. Obtener el Video
Cuando la tarea alcance el estado Succeed, lea la URL del Video generado en results.videos[].url.
La respuesta también puede incluir:
reason
results.timings.inference
results.seed
No asuma que un código de estado HTTP correcto significa que la generación ha finalizado. Su aplicación aún debe evaluar el campo de estado de la tarea.
5. Almacenar el resultado
La URL del Video devuelta es temporal. Descargue el resultado con prontitud y muévalo al almacenamiento controlado por su aplicación.
No utilice la URL de generación como la ubicación permanente de los archivos multimedia en su base de datos.
Cómo enviar una solicitud de generación de Video con SiliconFlow
Configurar la autenticación de la API
Cree una clave de API en la consola de SiliconFlow y guárdela en una variable de entorno:
Mantenga las claves de producción fuera del código fuente, los repositorios públicos, los paquetes de frontend y los registros de la aplicación.
Seleccionar el modelo de generación de Video
SiliconFlow proporciona acceso listo para usar a modelos de Video a través de Serverless Inference, para que los desarrolladores puedan añadir capacidades de generación sin necesidad de aprovisionar un entorno de GPU independiente.
Para la generación de text-to-video, este artículo utiliza:
Ambos modelos están disponibles actualmente a través de SiliconFlow Serverless. La disponibilidad de los modelos puede cambiar, por lo que las aplicaciones en producción deben confirmar el ID del modelo activo antes del despliegue.
Escribir un prompt de Video claro
Un buen prompt de Video debe explicar qué sucede a lo largo del tiempo, no solo qué contiene la escena.
Incluya detalles como:
El sujeto principal
La acción principal
El orden de los acontecimientos
El entorno
La posición o el movimiento de la cámara
La iluminación cuando sea relevante
Por ejemplo:
A small research drone flies above a green valley at sunrise.
Thecamera follows from behind withsteady forward movement.
Softmorning light passes through low clouds
A small research drone flies above a green valley at sunrise.
Thecamera follows from behind withsteady forward movement.
Softmorning light passes through low clouds
A small research drone flies above a green valley at sunrise.
Thecamera follows from behind withsteady forward movement.
Softmorning light passes through low clouds
Mantenga la descripción centrada y cronológica. SiliconFlow recomienda redactar el prompt en un único párrafo cohesionado, comenzando con la acción principal y manteniéndolo por debajo de las 200 palabras.
¿En qué se diferencian las solicitudes de Text-to-Video e Image-to-Video?
Ambos flujos de trabajo utilizan los mismos endpoints de envío y de estado. Su principal diferencia es el Input de generación.
Integración de la API de Text-to-Video
Una solicitud de text-to-video crea la escena a partir de un prompt de Text.
text_to_video_payload = {"model": "Wan-AI/Wan2.2-T2V-A14B","prompt": ("A small research drone flies above a green valley at sunrise. ""The camera follows from behind with steady forward movement. ""Soft morning light passes through low clouds."),"image_size": "1280x720","negative_prompt": ("flickering, distorted landscape, unstable camera"),"seed": 123456,}
text_to_video_payload = {"model": "Wan-AI/Wan2.2-T2V-A14B","prompt": ("A small research drone flies above a green valley at sunrise. ""The camera follows from behind with steady forward movement. ""Soft morning light passes through low clouds."),"image_size": "1280x720","negative_prompt": ("flickering, distorted landscape, unstable camera"),"seed": 123456,}
text_to_video_payload = {"model": "Wan-AI/Wan2.2-T2V-A14B","prompt": ("A small research drone flies above a green valley at sunrise. ""The camera follows from behind with steady forward movement. ""Soft morning light passes through low clouds."),"image_size": "1280x720","negative_prompt": ("flickering, distorted landscape, unstable camera"),"seed": 123456,}
Las opciones actuales de tamaño para text-to-video incluyen:
Formato
image_size
Panorámico
1280x720
Vertical
720x1280
Cuadrado
960x960
La semilla (seed) es opcional. Guárdela junto con el resultado cuando necesite un registro de los ajustes de generación.
Flujo de trabajo de la API de Image-to-Video
Una solicitud de image-to-video comienza a partir de una Image existente. El prompt debe centrarse en el movimiento, el comportamiento de la cámara y los cambios que deben producirse tras el primer fotograma.
image_to_video_payload = {"model": "Wan-AI/Wan2.2-I2V-A14B","prompt": ("The camera slowly moves forward. Clouds drift across the sky, ""and the grass moves gently in the wind."),"image": "https://example.com/source-image.jpg","negative_prompt": ("flickering, warped objects, sudden camera movement"),"seed": 123456,}
image_to_video_payload = {"model": "Wan-AI/Wan2.2-I2V-A14B","prompt": ("The camera slowly moves forward. Clouds drift across the sky, ""and the grass moves gently in the wind."),"image": "https://example.com/source-image.jpg","negative_prompt": ("flickering, warped objects, sudden camera movement"),"seed": 123456,}
image_to_video_payload = {"model": "Wan-AI/Wan2.2-I2V-A14B","prompt": ("The camera slowly moves forward. Clouds drift across the sky, ""and the grass moves gently in the wind."),"image": "https://example.com/source-image.jpg","negative_prompt": ("flickering, warped objects, sudden camera movement"),"seed": 123456,}
La Image de origen también se puede suministrar en un formato URI de datos Base64 admitido cuando sea adecuado para el esquema de la solicitud.
Para la generación de image-to-video, la resolución de Output se ajusta automáticamente a la relación de aspecto de la Image cargada:
Relación de aspecto de la Image de origen
Resolución de Output
16:9
1280 × 720
9:16
720 × 1280
1:1
960 × 960
Utilice una Image de origen con una de estas proporciones para reducir recortes o cambios de diseño imprevistos. No agregue manualmente image_size al payload de image-to-video a menos que el esquema actual de la API para el modelo seleccionado lo requiera.
Cómo consultar el estado del Video sin enviar solicitudes excesivas
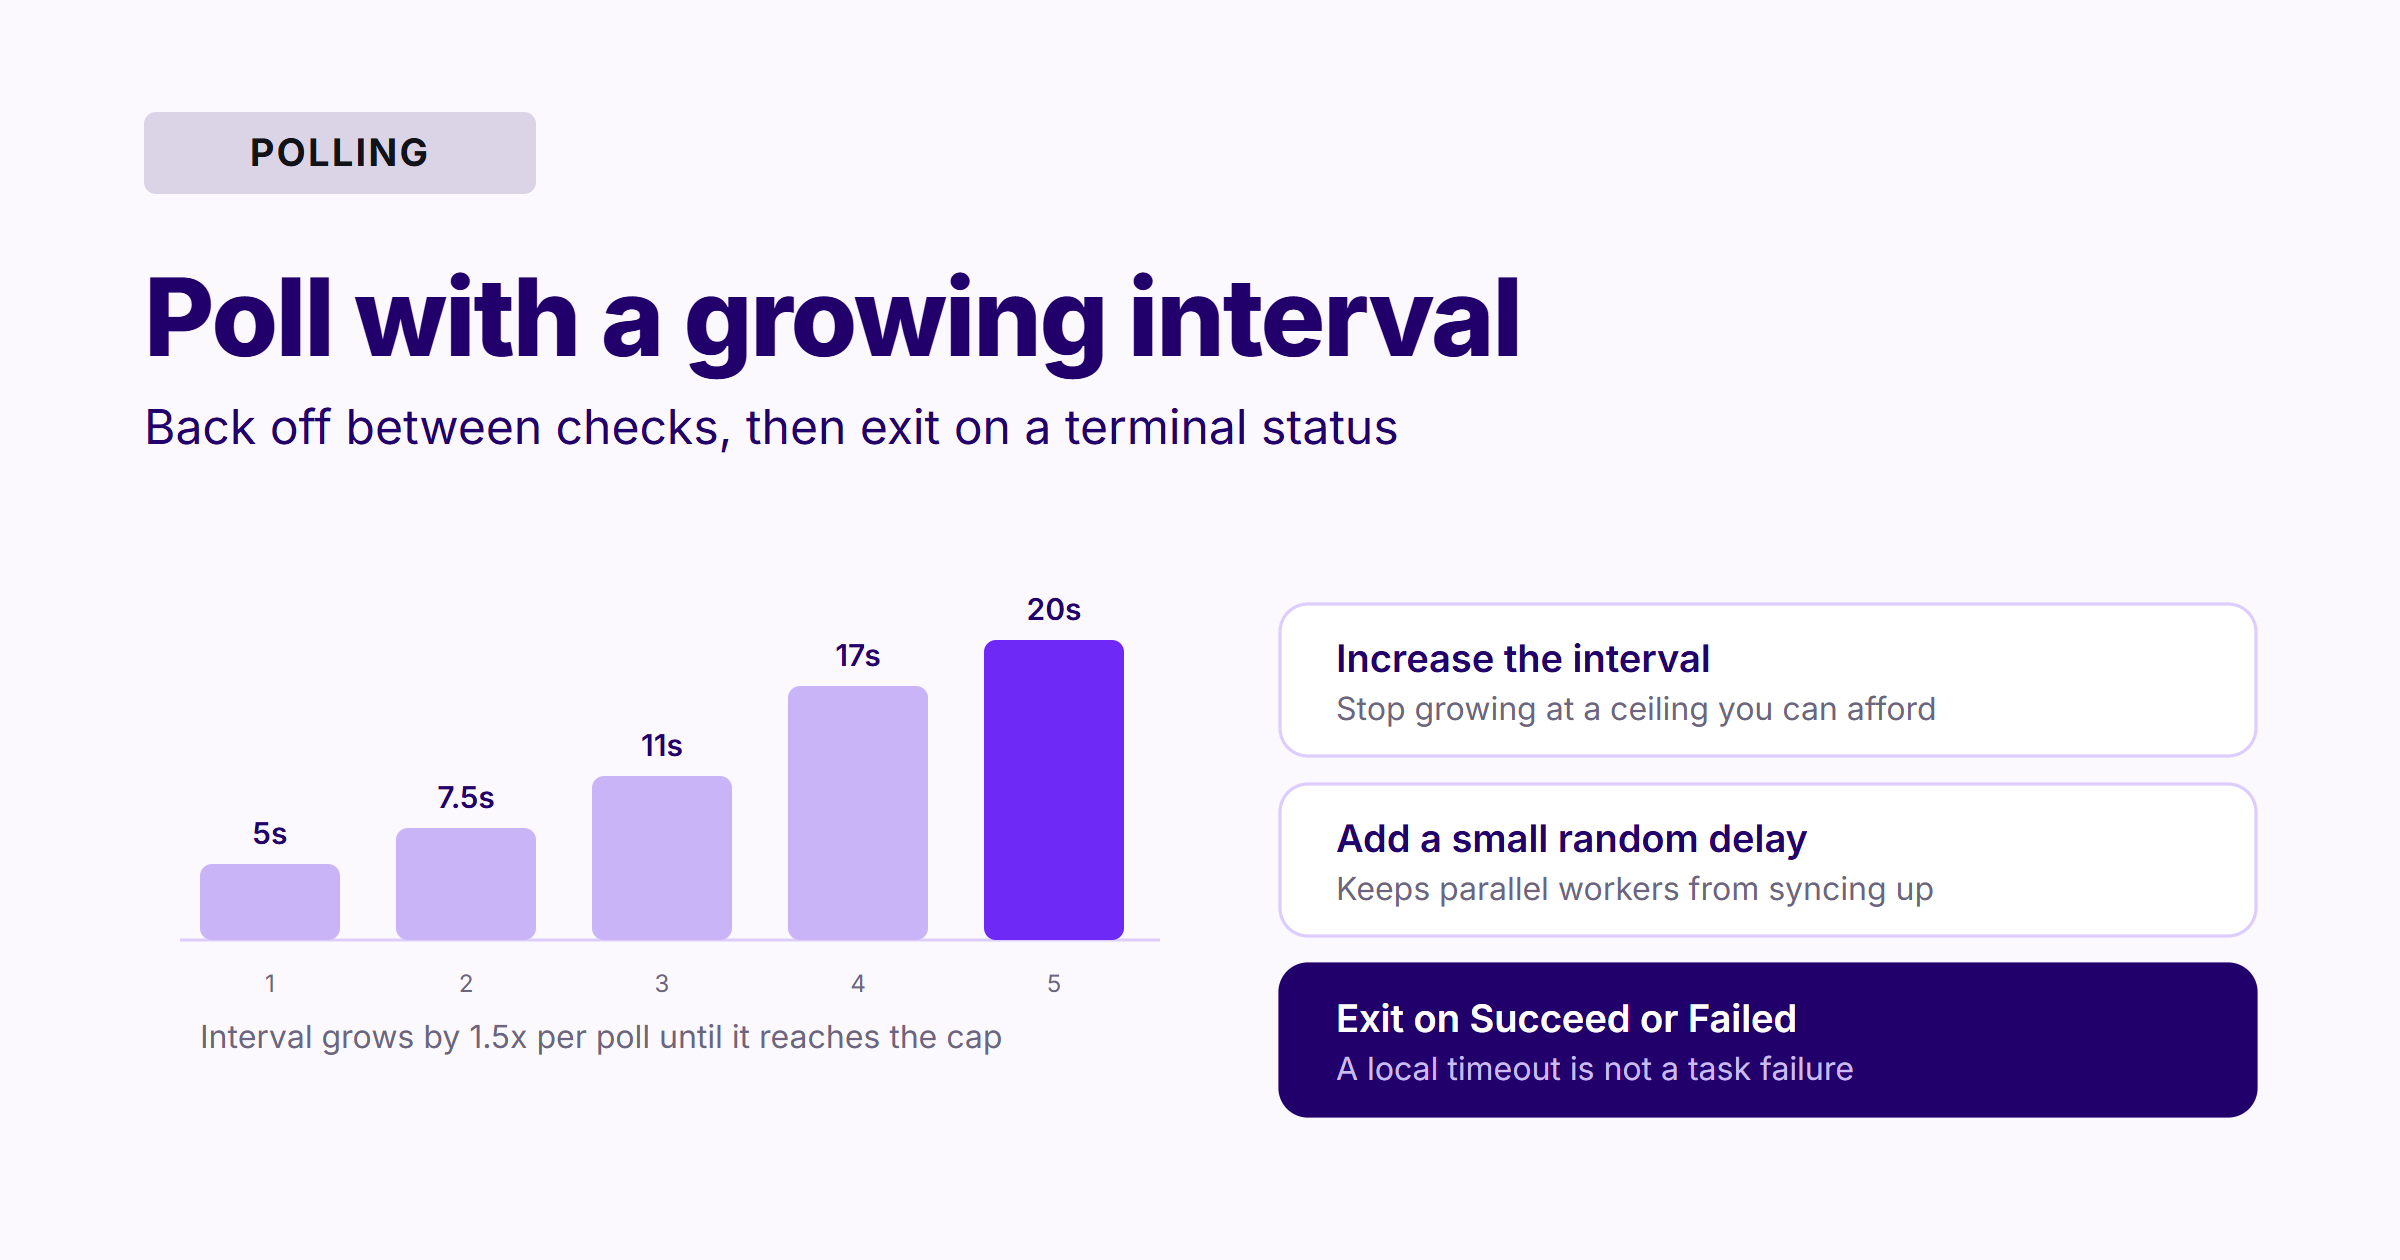
El sondeo (polling) debe actualizar la aplicación sin enviar solicitudes continuas.
Una estrategia práctica debería:
Esperar entre comprobaciones de estado
Aumentar el intervalo mientras la tarea permanezca sin finalizar
Añadir un pequeño retardo aleatorio cuando muchos trabajadores estén realizando consultas
Detenerse después de alcanzar Succeed o Failed
Aplicar un periodo máximo de espera local
Conservar el requestId cuando se detenga el sondeo local
Un tiempo de espera local no significa que la tarea de generación haya fallado. Solo significa que el proceso actual ha dejado de esperar. Otro trabajador puede reanudar el sondeo con el mismo requestId.
No envíe inmediatamente una segunda solicitud de generación solo porque la primera permanezca en InQueue. Hacerlo puede generar vídeos duplicados y un consumo innecesario.
Cómo gestionar el estado y los fallos en la generación de Video
Un error HTTP y una tarea con el estado Failed son condiciones diferentes.
Solo vale la pena reintentar sin modificaciones los errores 429, 503 y 504.
Resultado
Significado probable
Gestión recomendada
400
Parámetros de solicitud no válidos
Corregir la solicitud antes de reintentar
401
Clave de API ausente o no válida
Comprobar la autenticación
403
Acceso insuficiente
Comprobar los permisos de la cuenta y del modelo
429
Se ha alcanzado un límite de velocidad (rate limit)
Esperar y reintentar con retroceso exponencial
503 o 504
Problema temporal de carga o servicio
Utilizar reintentos delimitados
500
Error inesperado del servicio
Registrar la respuesta e investigar
Status Failed
La tarea de generación ha fallado
Leer el motivo antes de volver a enviarla
No reintente las respuestas 400, 401 o 403 con la misma solicitud sin cambios.
Para 429, 503 y 504, utilice un número limitado de reintentos con intervalos crecientes. Los límites de velocidad se aplican a nivel de cuenta, mientras que los diferentes modelos pueden tener límites distintos.
Ejemplo integral en Python: Envío, sondeo y descarga
El siguiente ejemplo envía una solicitud de text-to-video, reintenta fallos temporales de la API, consulta el estado con un intervalo creciente y descarga el resultado.
importosimportrandomimporttimefrompathlibimportPathfromtypingimportAnyimportrequestsAPI_KEY = os.environ["SILICONFLOW_API_KEY"]BASE_URL = "https://api.siliconflow.com/v1"MAX_API_RETRIES = 4MAX_WAIT_SECONDS = 15 * 60INITIAL_POLL_SECONDS = 5MAX_POLL_SECONDS = 20RETRYABLE_STATUS_CODES = {429,503,504}HEADERS = {"Authorization": f"Bearer {API_KEY}","Content-Type": "application/json",}defpost_json_with_retry(url: str,payload: dict[str,Any],) -> requests.Response:
"""Send a POST request with bounded retries."""forattemptinrange(MAX_API_RETRIES + 1):
try:
response = requests.post(url,headers=HEADERS,json=payload,timeout=30,)except(requests.Timeout,requests.ConnectionError):
ifattempt == MAX_API_RETRIES:
raisedelay = min((2**attempt) + random.uniform(0,1),20)time.sleep(delay)continueifresponse.status_codenotinRETRYABLE_STATUS_CODES:
response.raise_for_status()returnresponseifattempt == MAX_API_RETRIES:
response.raise_for_status()delay = min((2**attempt) + random.uniform(0,1),20)print(f"Temporary HTTP {response.status_code}. "f"Retrying in {delay:.1f} seconds.")time.sleep(delay)raiseRuntimeError("The API request failed after all retries.")defsubmit_video(payload: dict[str,Any]) -> str:
response = post_json_with_retry(f"{BASE_URL}/video/submit",payload,)request_id = response.json().get("requestId")ifnotrequest_id:
raiseRuntimeError("The submission response did not contain a requestId.")returnrequest_iddefget_video_status(request_id: str) -> dict[str,Any]:
response = post_json_with_retry(f"{BASE_URL}/video/status",{"requestId": request_id},)returnresponse.json()defwait_for_video(request_id: str) -> dict[str,Any]:
deadline = time.monotonic() + MAX_WAIT_SECONDSpoll_seconds = INITIAL_POLL_SECONDSwhiletime.monotonic() < deadline:
data = get_video_status(request_id)status = data.get("status")ifstatusin{"InQueue","InProgress"}:
print(f"Current status: {status}")time.sleep(poll_seconds + random.uniform(0,1))poll_seconds = min(poll_seconds * 1.5,MAX_POLL_SECONDS,)continueifstatus == "Failed":
reason = data.get("reason")or("No failure reason was returned.")raiseRuntimeError(f"Video generation failed: {reason}")ifstatus == "Succeed":
videos = data.get("results",{}).get("videos",[])ifnotvideosornotvideos[0].get("url"):
raiseRuntimeError("The task succeeded, but no video URL was returned.")returndataraiseRuntimeError(f"Unexpected task status: {status!r}")raiseTimeoutError("Local polling ended before generation completed. "f"Save this requestId and check it later: {request_id}")defdownload_video(video_url: str,output_path: Path,) -> None:
withrequests.get(video_url,stream=True,timeout=120,)asresponse:
response.raise_for_status()content_type = response.headers.get("Content-Type","")ifcontent_typeandnotcontent_type.startswith("video/"):
raiseRuntimeError(f"Unexpected Content-Type: {content_type}")withoutput_path.open("wb")asoutput_file:
forchunkinresponse.iter_content(chunk_size=1024 * 1024):
ifchunk:
output_file.write(chunk)defmain() -> None:
payload = {"model": "Wan-AI/Wan2.2-T2V-A14B","prompt": ("A small research drone flies above a green valley ""at sunrise. The camera follows from behind with ""steady forward movement. Soft morning light passes ""through low clouds."),"image_size": "1280x720","negative_prompt": ("flickering, distorted landscape, unstable camera"),"seed": 123456,}request_id = submit_video(payload)print(f"Request submitted: {request_id}")result = wait_for_video(request_id)video_url = result["results"]["videos"][0]["url"]output_path = Path(f"{request_id}.mp4")download_video(video_url,output_path)inference_time = (result.get("results",{})
.get("timings",{})
.get("inference"))print(f"Video saved to: {output_path.resolve()}")ifinference_timeisnotNone:
print(f"Inference time: {inference_time}")if__name__ == "__main__":
main()
Los valores de sondeo de este ejemplo son configuraciones de la aplicación, no requisitos fijos de la API. Ajústelos según su carga de trabajo, la experiencia de usuario deseada y los límites de velocidad.
En una aplicación web de producción, ejecute el sondeo en un proceso de fondo (worker) en lugar de mantener abierta la solicitud original del navegador.
¿Cómo deben almacenar los vídeos generados las aplicaciones?
Descargar el resultado de inmediato
Comience a descargar tan pronto como la tarea alcance el estado Succeed.
Marque el trabajo como completamente terminado solo después de que el archivo haya sido transferido a su propio almacenamiento. Cuando la generación tenga éxito pero el almacenamiento falle, mantenga el trabajo en un estado independiente, como storage_pending, para que se pueda reintentar la transferencia del archivo.
Mover el archivo al almacenamiento de objetos
Cargue el resultado en el almacenamiento de objetos o en la plataforma de medios de su aplicación. Guarde la clave de objeto resultante en lugar de la URL de generación temporal.
Para contenido privado, mantenga el objeto con acceso restringido y genere URL firmadas cuando los usuarios necesiten acceder.
Guardar los metadatos de la generación
Un registro de producción puede incluir:
ID interno del trabajo
requestId de SiliconFlow
ID del modelo
Prompt o hash del prompt
Referencia a la Image de origen
Resolución de Output
Semilla (seed)
Estado actual de la tarea
Motivo del fallo
Tiempo de inferencia
Marcas de tiempo de envío y finalización
Clave de objeto en el almacenamiento
Tamaño del archivo o suma de comprobación (checksum)
No registre claves de API, imágenes en Base64 ni prompts sensibles en logs sin restricciones.
Establecer una directiva de retención
Defina cuánto tiempo permanecerán disponibles los archivos generados y los registros de las tareas. Elimine los archivos locales temporales tras una carga correcta, borre los trabajos abandonados de acuerdo con las directivas de la aplicación y admita la eliminación por parte del usuario cuando el producto lo requiera.
Con SiliconFlow, los desarrolladores pueden acceder a modelos de Text, Image, Audio y Video a través de una única plataforma. Esto reduce la necesidad de integrar y mantener un entorno de servicio independiente para cada capacidad de IA, al tiempo que admite un desarrollo de aplicaciones flexible y de pago por uso.
Preguntas frecuentes
¿Por qué una API de generación de Video devuelve un ID de solicitud?
La generación de Video es una tarea de larga duración. El requestId permite a su aplicación comprobar el progreso a través de un endpoint independiente sin mantener abierta la solicitud de envío inicial.
¿Puede una aplicación reanudar el sondeo tras un tiempo de espera local?
Sí. Guarde el requestId original y utilícelo en una solicitud de estado posterior. Un tiempo de espera local no cancela ni hace fallar automáticamente la tarea de generación en el servidor.
¿Debería enviar un nuevo trabajo si el estado permanece en InQueue?
No inmediatamente. Continúe sondeando a intervalos controlados a menos que la API devuelva Failed. Repetir el envío puede crear vídeos duplicados y un consumo innecesario.
¿Image-to-Video utiliza el mismo endpoint de estado?
Sí. Tanto las solicitudes de text-to-video como las de image-to-video se envían a través de /video/submit y se comprueban a través de /video/status. El payload de Input cambia, pero el flujo de trabajo asíncrono sigue siendo el mismo.
¿Se pueden almacenar permanentemente los vídeos generados por IA?
Sí. Descargue el resultado mientras su URL temporal esté disponible y transfiéralo a su propio sistema de almacenamiento. Guarde su clave de almacenamiento o la URL multimedia interna en lugar de depender de la URL de generación.