Configuración de OpenAI SDK para la integración de la API de SiliconFlow
Índice de contenidos
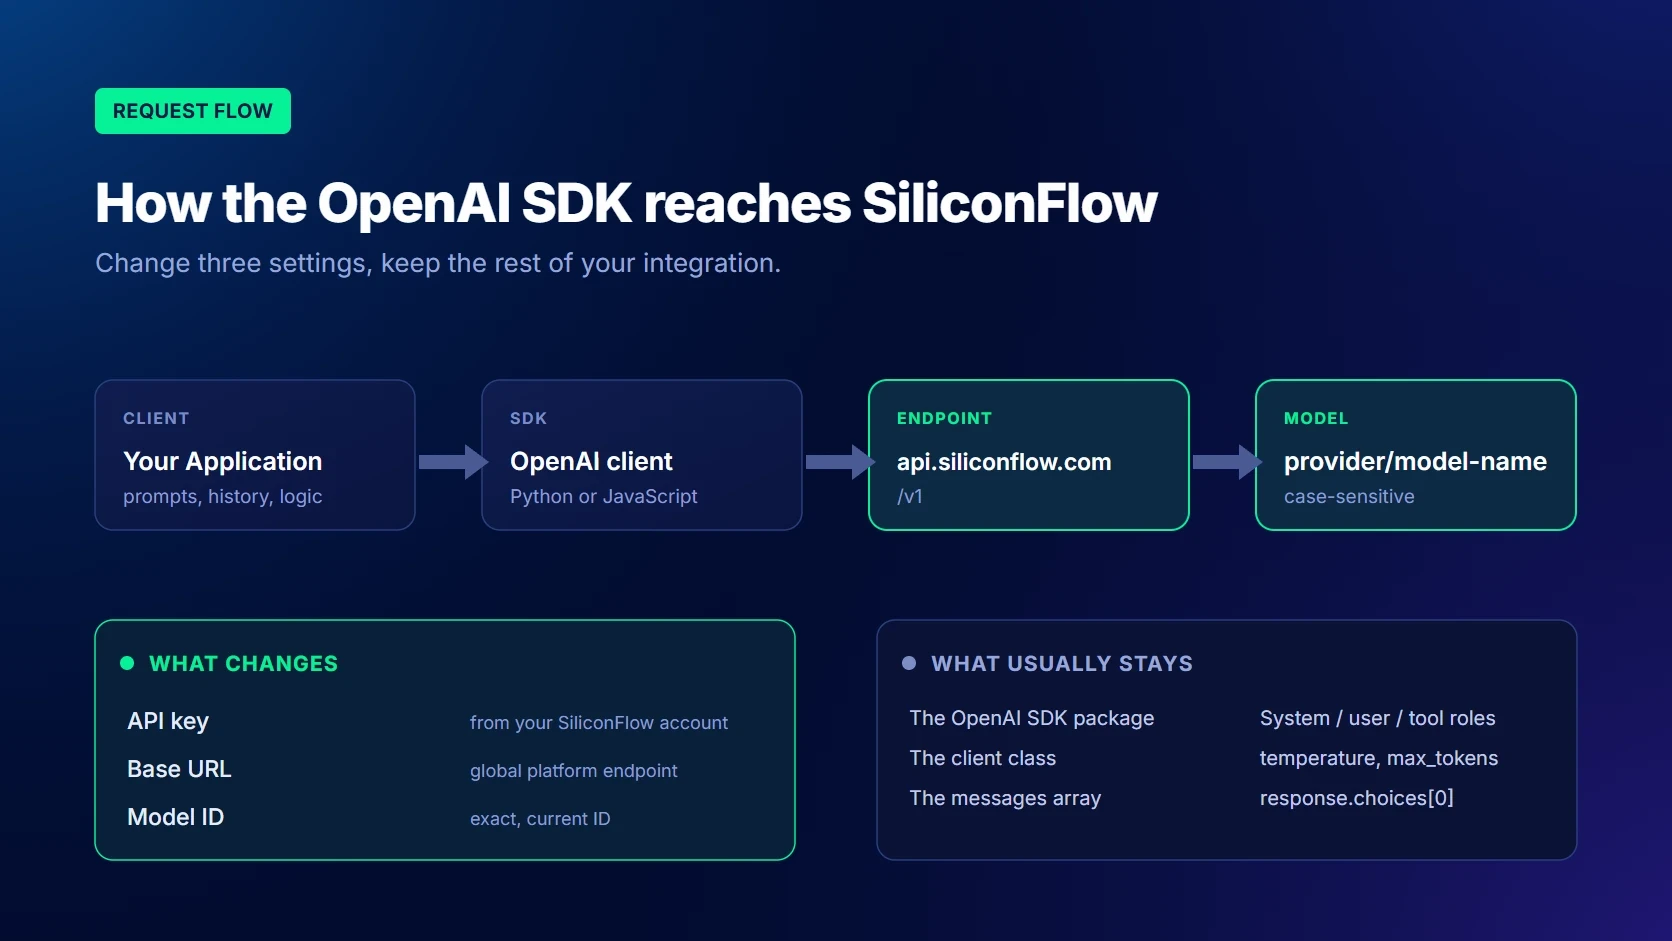
Puede utilizar el SDK de OpenAI con SiliconFlow cambiando tres configuraciones principales: la API Key, la URL base y el ID del modelo. Para las aplicaciones creadas en torno a Chat Completions, gran parte de la lógica existente del cliente, los mensajes y la gestión de respuestas puede permanecer sin cambios. Sin embargo, que sea compatible con OpenAI no significa que cada endpoint o función avanzada se comporte de forma idéntica. Esta guía explica la configuración requerida, proporciona ejemplos en Python y JavaScript, y muestra cómo probar streaming, herramientas, salidas estructuradas, vision, razonamiento, límites y errores antes de la producción.
¿Qué significa una API compatible con OpenAI para los desarrolladores?
Una API compatible con OpenAI sigue los patrones de solicitud y respuesta habituales utilizados por el SDK de OpenAI. En lugar de reemplazar el SDK o reconstruir toda la capa de integración de la aplicación, los desarrolladores pueden configurar el cliente existente para enviar solicitudes a SiliconFlow.
Para los modelos de lenguaje compatibles, la aplicación puede seguir utilizando el método Chat Completions:
client.chat.completions.create()
La URL base de la API global de SiliconFlow es:
https://api.siliconflow.com/v1
El inicio rápido actual utiliza este endpoint con la biblioteca OpenAI de Python y señala que la plataforma admite la mayoría de los parámetros relacionados con OpenAI.
¿Qué puede permanecer igual habitualmente?
Para una aplicación estándar de generación de texto, los siguientes elementos a menudo pueden permanecer sin cambios:
El paquete SDK de OpenAI
La clase de cliente de OpenAI
El método chat.completions.create()
El array de mensajes
Los roles de sistema, usuario, asistente y herramientas
Parámetros básicos como temperature, max_tokens y stream
El análisis de la respuesta final a través de response.choices[0].message.content
Esto reduce el trabajo de migración porque la aplicación puede conservar su construcción de prompts, el historial de conversaciones y la lógica empresarial principal existentes.
También facilita la evaluación de modelos. Cuando la configuración del proveedor y el ID del modelo se guardan en la configuración, los equipos pueden probar diferentes modelos sin necesidad de crear una integración de SDK independiente para cada uno.
¿Qué sigue dependiendo del proveedor de la API y del modelo?
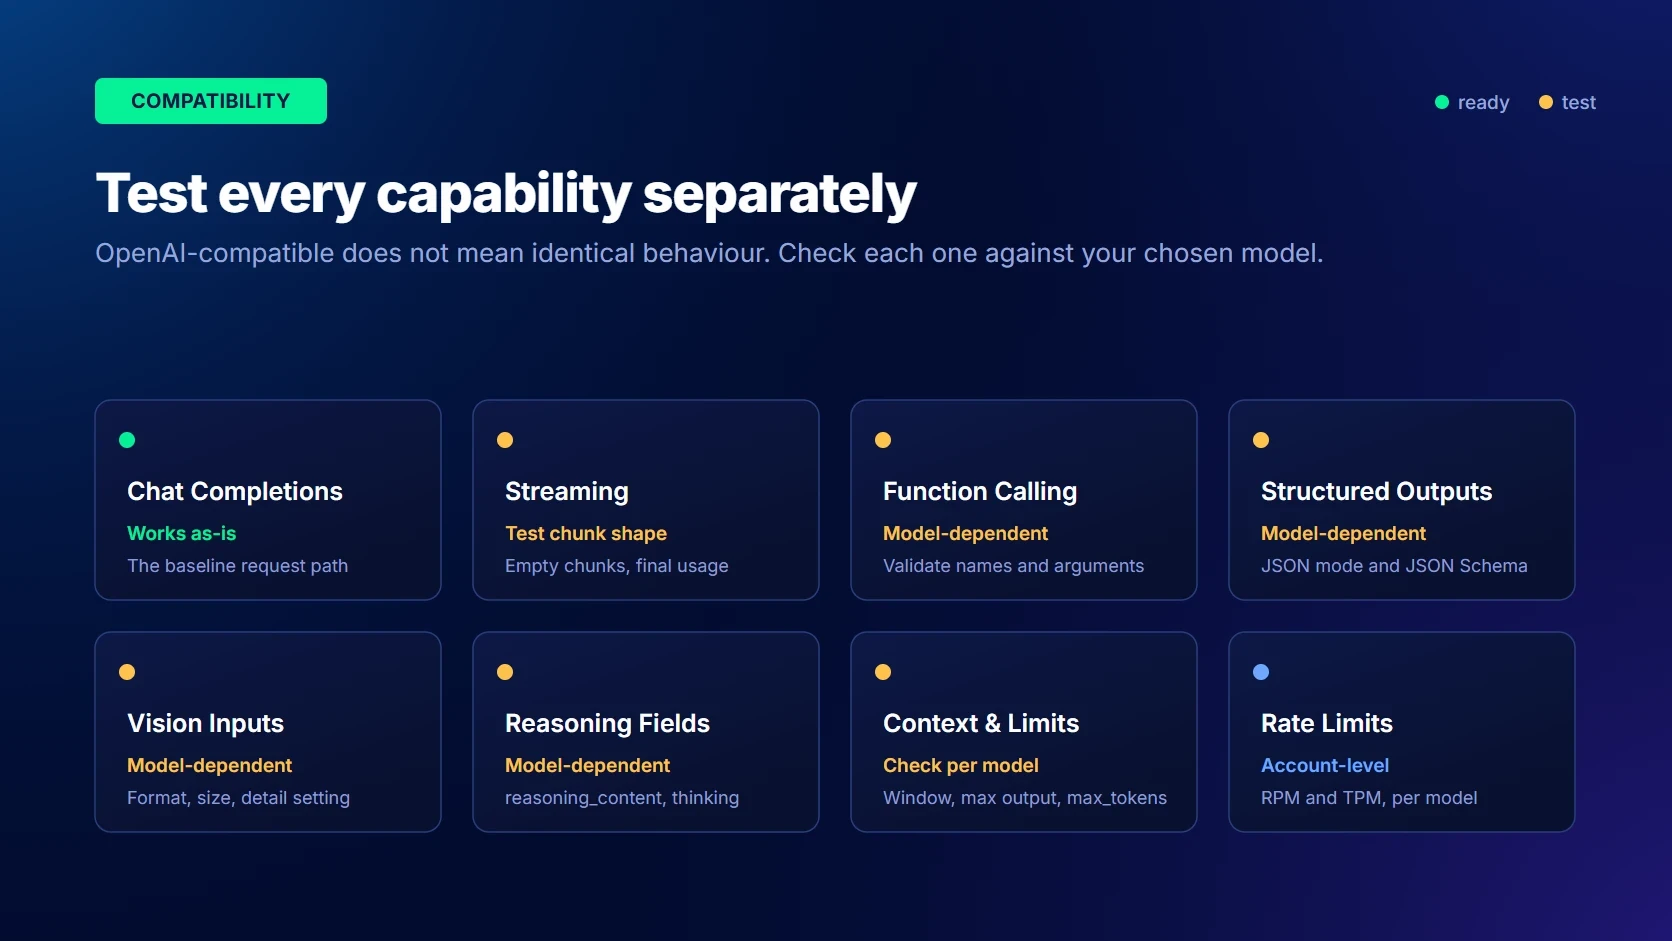
Ser compatible con OpenAI no significa que cada endpoint o característica del modelo de OpenAI se reproduzca de manera idéntica.
Las siguientes áreas aún requieren pruebas de compatibilidad:
IDs de modelos disponibles
Parámetros de solicitud admitidos
Ventanas de contexto y límites de salida
Comportamiento de la llamada a funciones (Function Calling)
JSON Mode y salidas estructuradas
Entradas de vision y multimodalidad
Controles de razonamiento
Campos de respuesta adicionales
Comportamiento de los fragmentos de streaming (chunks)
Límites de tarifa (Rate limits)
Disponibilidad del modelo
El enfoque más seguro es tratar la compatibilidad de la API como una forma de reducir el trabajo de integración, no como un sustituto de las pruebas del modelo seleccionado.
¿Qué cambia al conectar una aplicación del SDK de OpenAI a SiliconFlow?
API Key y autenticación
Cree una API Key en la plataforma de SiliconFlow y guárdela en una variable de entorno:
exportSILICONFLOW_API_KEY="your-api-key"
exportSILICONFLOW_API_KEY="your-api-key"
exportSILICONFLOW_API_KEY="your-api-key"
El SDK de OpenAI envía la clave mediante autenticación Bearer cuando se inicializa el cliente.
No exponga las claves API en:
Código fuente
Repositorios públicos
Aplicaciones de navegador
Salidas de logs
Capturas de pantalla
Archivos de configuración compartidos
Las aplicaciones en producción deben cargar las credenciales desde un entorno protegido del lado del servidor o un gestor de secretos.
La API Key debe pertenecer a la plataforma asociada con el endpoint seleccionado. Evite mezclar credenciales o URLs base de la plataforma global y de la plataforma de China.
IDs de modelos de SiliconFlow
El campo model debe contener exactamente el ID del modelo disponible a través de SiliconFlow. Los IDs de modelos suelen seguir este formato:
proveedor/nombre-del-modelo
Los IDs de los modelos distinguen entre mayúsculas y minúsculas. Un nombre abreviado, una variación ortográfica o un ID retirado pueden hacer que la solicitud falle.
Consulte la página actual de Modelos antes de la implementación. También puede recuperar los IDs de modelos disponibles de forma programática a través del endpoint /v1/models:
GET https://api.siliconflow.com/v1/models
Authorization:Bearer YOUR_SILICONFLOW_API_KEY
GET https://api.siliconflow.com/v1/models
Authorization:Bearer YOUR_SILICONFLOW_API_KEY
GET https://api.siliconflow.com/v1/models
Authorization:Bearer YOUR_SILICONFLOW_API_KEY
El endpoint de listado de modelos puede filtrar los resultados por tipo o subtipo de modelo, incluidos modelos de chat, embedding, reranker, image, audio y video.
Mantenga el ID del modelo en una variable de entorno o archivo de configuración en lugar de repetirlo por todo el código base.
Parámetros de solicitud y soporte específico del modelo
Los parámetros comunes de Chat Completions incluyen:
model
messages
stream
temperature
top_p
max_tokens
stop
tools
response_format
Los parámetros avanzados pueden aplicarse solo a modelos específicos:
enable_thinking
thinking_budget
min_p
tools
response_format
image_url
detail
No copie automáticamente todos los parámetros utilizados con otro proveedor. Comience con una solicitud mínima que contenga solo model y messages, luego agregue los parámetros opcionales individualmente.
Los campos específicos del proveedor se pueden pasar a través de extra_body en Python:
Incluya estos campos únicamente tras confirmar que el modelo seleccionado los admite.
Campos de respuesta y gestión de errores
Una respuesta estándar sin streaming suele estar disponible en:
response.choices[0].message.content
Los modelos de razonamiento también pueden devolver:
response.choices[0].message.reasoning_content
Las aplicaciones no deben asumir que cada respuesta contiene un array choices que no esté vacío o que cada modelo devuelve los mismos campos. Valide la respuesta antes de acceder a los valores anidados.
Paso a paso: Conectar una aplicación del SDK de OpenAI a SiliconFlow
Copie exactamente el ID del modelo de la página actual de Modelos en lugar de confiar en un ejemplo estático que podría quedar desactualizado.
Inicializar el cliente de SiliconFlow
Python:
importosfromopenaiimportOpenAIapi_key = os.getenv("SILICONFLOW_API_KEY")model_id = os.getenv("SILICONFLOW_MODEL")ifnotapi_key:
raiseRuntimeError("SILICONFLOW_API_KEY is not configured.")ifnotmodel_id:
raiseRuntimeError("SILICONFLOW_MODEL is not configured.")client = OpenAI(api_key=api_key,base_url=os.getenv("SILICONFLOW_BASE_URL","https://api.siliconflow.com/v1",),)
JavaScript:
importOpenAIfrom"openai";constapiKey = process.env.SILICONFLOW_API_KEY;constmodel = process.env.SILICONFLOW_MODEL;if(!apiKey){thrownewError("SILICONFLOW_API_KEY is not configured.");}if(!model){thrownewError("SILICONFLOW_MODEL is not configured.");}constclient = newOpenAI({apiKey,baseURL:process.env.SILICONFLOW_BASE_URL ??
"https://api.siliconflow.com/v1",});
Seleccionar un ID de modelo disponible
Antes de elegir un modelo para producción, verifique:
Tipos de entrada admitidos
Ventana de contexto
Salida máxima
Soporte de herramientas
Soporte de salida estructurada
Comportamiento de razonamiento
Latencia esperada
Precio actual del token
Disponibilidad
SiliconFlow proporciona acceso a modelos lingüísticos y multimodales a través de un flujo de trabajo de API coherente, lo que permite a los desarrolladores seleccionar modelos según los requisitos de cada tarea.
Enviar y verificar la primera solicitud
Comience con una solicitud mínima sin streaming:
response = client.chat.completions.create(model=model_id,messages=[{"role": "user","content": "Reply with exactly: Connection successful",}],temperature=0,max_tokens=20,)ifnotresponse.choices:
raiseRuntimeError("The API returned no completion choices.")print(response.choices[0].message.content)
response = client.chat.completions.create(model=model_id,messages=[{"role": "user","content": "Reply with exactly: Connection successful",}],temperature=0,max_tokens=20,)ifnotresponse.choices:
raiseRuntimeError("The API returned no completion choices.")print(response.choices[0].message.content)
response = client.chat.completions.create(model=model_id,messages=[{"role": "user","content": "Reply with exactly: Connection successful",}],temperature=0,max_tokens=20,)ifnotresponse.choices:
raiseRuntimeError("The API returned no completion choices.")print(response.choices[0].message.content)
Verifique que:
La solicitud llegue al endpoint previsto.
El modelo acepte la solicitud.
La respuesta contenga al menos una opción.
El contenido se pueda analizar correctamente.
La solicitud se complete dentro del tiempo de espera esperado.
Las credenciales no aparezcan en los logs.
Pruebe las funciones avanzadas solo después de que la solicitud básica funcione correctamente.
Ejemplo en Python: Usar el SDK de OpenAI con SiliconFlow
importosimportsysfromopenaiimport(APIConnectionError,APIStatusError,APITimeoutError,OpenAI,)api_key = os.getenv("SILICONFLOW_API_KEY")base_url = os.getenv("SILICONFLOW_BASE_URL","https://api.siliconflow.com/v1",)model_id = os.getenv("SILICONFLOW_MODEL")ifnotapi_key:
raiseRuntimeError("SILICONFLOW_API_KEY is not configured.")ifnotmodel_id:
raiseRuntimeError("SILICONFLOW_MODEL is not configured.")client = OpenAI(api_key=api_key,base_url=base_url,timeout=60.0,max_retries=2,)try:
response = client.chat.completions.create(model=model_id,messages=[{"role": "system","content": "You are a concise technical assistant.",},{"role": "user","content": ("Explain one benefit of an ""OpenAI-compatible API."),},],temperature=0.2,max_tokens=200,)ifnotresponse.choices:
raiseRuntimeError("The API returned no completion choices.")print(response.choices[0].message.content)exceptAPITimeoutError:
print("The request timed out.",file=sys.stderr)exceptAPIConnectionErroraserror:
print(f"Unable to connect to SiliconFlow: {error}",file=sys.stderr,)exceptAPIStatusErroraserror:
print(f"SiliconFlow returned HTTP {error.status_code}: "f"{error.response}",file=sys.stderr,)
Este ejemplo mantiene las credenciales, la URL base y el ID del modelo fuera del código fuente, mientras gestiona tiempos de espera, fallos de conexión y respuestas HTTP que no son exitosas.
Ejemplo en JavaScript y TypeScript: Usar el SDK de OpenAI con SiliconFlow
importOpenAIfrom"openai";constapiKey = process.env.SILICONFLOW_API_KEY;constbaseURL =
process.env.SILICONFLOW_BASE_URL ??
"https://api.siliconflow.com/v1";constmodel = process.env.SILICONFLOW_MODEL;if(!apiKey){thrownewError("SILICONFLOW_API_KEY is not configured.");}if(!model){thrownewError("SILICONFLOW_MODEL is not configured.");}constclient = newOpenAI({apiKey,baseURL,timeout:60_000,maxRetries:2,});asyncfunctionmain(){try{constresponse = awaitclient.chat.completions.create({model,messages:[{role:"system",content:"You are a concise technical assistant.",},{role:"user",content:"Explain one benefit of an OpenAI-compatible API.",},],temperature:0.2,max_tokens:200,});constcontent = response.choices[0]?.message?.content;if(!content){thrownewError("The API returned no assistant content.");}console.log(content);}catch(error){if(errorinstanceofOpenAI.APIError){console.error(`SiliconFlow API error ${error.status}: ${error.message}`);return;}console.error("Request failed:",error);}}main();
Mantenga la API Key en el servidor. No incluya una API Key permanente en los paquetes del frontend ni en el código fuente del navegador.
¿Qué funciones de la API requieren pruebas de compatibilidad adicionales?
Respuestas en streaming y análisis de fragmentos (Chunks)
El inicio rápido oficial verifica si hay choices vacías y maneja tanto el content como el reasoning_content en las respuestas transmitidas en streaming.
Pruebe:
Fragmentos (chunks) vacíos
Finalización del stream
Interrupciones de la conexión
Tiempos de espera (Timeouts)
Campos de razonamiento
Informe de uso final
Evite los analizadores (parsers) que dependen de campos de eventos no documentados de otro proveedor.
Llamada a funciones y llamadas a herramientas (Tool Calls)
La llamada a funciones utiliza el conocido parámetro tools al estilo de OpenAI:
tools = [{"type": "function","function": {"name": "get_order_status","description": "Get the status of an order.","parameters": {"type": "object","properties": {"order_id": {"type": "string"}},"required": ["order_id"]}}}]
tools = [{"type": "function","function": {"name": "get_order_status","description": "Get the status of an order.","parameters": {"type": "object","properties": {"order_id": {"type": "string"}},"required": ["order_id"]}}}]
tools = [{"type": "function","function": {"name": "get_order_status","description": "Get the status of an order.","parameters": {"type": "object","properties": {"order_id": {"type": "string"}},"required": ["order_id"]}}}]
SiliconFlow permite pasar tools a través de client.chat.completions.create(), pero la disponibilidad de las herramientas sigue dependiendo del modelo.
La aplicación es responsable de:
Validar el nombre de la función solicitada
Analizar y validar los argumentos
Aplicar reglas de autorización
Ejecutar la herramienta
Devolver el resultado al modelo
Evitar acciones externas duplicadas
Pruebe el modelo exacto y la configuración de las herramientas antes de habilitar el flujo de trabajo en producción.
Salidas estructuradas y JSON Schema
El JSON Mode solicita un JSON válido:
json_model = os.getenv("SILICONFLOW_JSON_MODEL",model_id,)response = client.chat.completions.create(model=json_model,messages=[{"role": "system","content": "Return valid JSON only.",},{"role": "user","content": ("Return an object with summary ""and risk_level fields."),},],response_format={"type": "json_object"},)
json_model = os.getenv("SILICONFLOW_JSON_MODEL",model_id,)response = client.chat.completions.create(model=json_model,messages=[{"role": "system","content": "Return valid JSON only.",},{"role": "user","content": ("Return an object with summary ""and risk_level fields."),},],response_format={"type": "json_object"},)
json_model = os.getenv("SILICONFLOW_JSON_MODEL",model_id,)response = client.chat.completions.create(model=json_model,messages=[{"role": "system","content": "Return valid JSON only.",},{"role": "user","content": ("Return an object with summary ""and risk_level fields."),},],response_format={"type": "json_object"},)
Las salidas estructuradas añaden un esquema JSON. Establezca un modelo que admita actualmente esta función en lugar de asumir que todos los modelos se comportan de la misma manera:
structured_model = os.getenv("SILICONFLOW_STRUCTURED_MODEL")ifnotstructured_model:
raiseRuntimeError("SILICONFLOW_STRUCTURED_MODEL is not configured.")response = client.chat.completions.create(model=structured_model,messages=[{"role": "user","content": "Classify this support request.",}],response_format={"type": "json_schema","json_schema": {"name": "support_classification","schema": {"type": "object","properties": {"category": {"type": "string","enum": ["billing","technical","account"]},"urgent": {"type": "boolean"}},"required": ["category","urgent"],"additionalProperties": False}}},)
El JSON Mode se centra en devolver un JSON válido, mientras que Structured Outputs aplica restricciones de esquema, una distinción que también se documenta en la guía de Structured Outputs de OpenAI. La guía actual de SiliconFlow también recomienda dejar suficiente presupuesto de salida para evitar un JSON incompleto.
Las aplicaciones en producción aún deben gestionar respuestas vacías, truncamientos, fallos de análisis y validación de reglas de negocio.
Entradas de Vision e Image
Los modelos con capacidad de Vision admiten URLs de Image o imágenes codificadas en Base64 a través de Chat Completions:
vision_model = os.getenv("SILICONFLOW_VISION_MODEL")ifnotvision_model:
raiseRuntimeError("SILICONFLOW_VISION_MODEL is not configured.")response = client.chat.completions.create(model=vision_model,messages=[{"role": "user","content": [{"type": "image_url","image_url": {"url": "https://example.com/image.jpg","detail": "high"}},{"type": "text","text": "Describe this image."}]}],)
El parámetro detail admite low, high y auto para modelos compatibles. El comportamiento actual, los límites de Image y el preprocesamiento pueden variar según el modelo.
Pruebe:
Soporte de Vision
Accesibilidad de la Image
Formato de archivo y tamaño de carga útil (payload)
Comportamiento con múltiples imágenes
Configuraciones de detalle
Latencia y uso de tokens
Un formato de mensaje Multimodal válido no hace que un modelo de solo texto acepte imágenes.
Resultados de razonamiento y parámetros de pensamiento
Los modelos de razonamiento pueden devolver el contenido del razonamiento y la respuesta final por separado:
reasoning_model = os.getenv("SILICONFLOW_REASONING_MODEL")ifnotreasoning_model:
raiseRuntimeError("SILICONFLOW_REASONING_MODEL is not configured.")response = client.chat.completions.create(model=reasoning_model,messages=[{"role": "user","content": "Compare two database indexing strategies.",}],extra_body={"thinking_budget": 1024},)message = response.choices[0].messagereasoning_content = getattr(message,"reasoning_content",None,)final_answer = message.content
La guía de razonamiento de SiliconFlow documenta los parámetros reasoning_content y thinking_budget para los modelos de razonamiento compatibles.
No asuma que un modelo utilizado para la generación básica de Text admite campos de razonamiento o controles de pensamiento. Las aplicaciones también deben decidir si el contenido del razonamiento debe mostrarse, almacenarse, excluirse de los logs o conservarse durante los flujos de trabajo de las herramientas.
Ventanas de contexto y límites de tokens
La ventana de contexto, la salida máxima y los max_tokens están relacionados, pero no deben tratarse como valores intercambiables.
La solicitud completa puede incluir:
Mensajes del sistema y del usuario
Historial de conversaciones
Definiciones de herramientas
Esquemas JSON
Imágenes
Documentos recuperados
Salida generada
tokens de razonamiento
Verifique los detalles del modelo actual en lugar de aplicar un único límite de tokens a todos los modelos. Realice pruebas con prompts representativos de producción, no solo con ejemplos cortos de desarrollo.
Problemas comunes de compatibilidad y cómo solucionarlos
API Key no válida o URL base incorrecta
Una respuesta 401 suele indicar que la API Key falta, no es válida o no está disponible.
Verifique:
Si SILICONFLOW_API_KEY está cargada
Si la clave contiene espacios accidentales
Si la URL base global correcta está configurada
Si la clave pertenece a la plataforma SiliconFlow
Si la aplicación se reinició después de realizar los cambios de configuración
Errores de modelo no encontrado (Model Not Found)
Los fallos relacionados con los modelos suelen deberse a:
Uso incorrecto de mayúsculas y minúsculas
Un nombre de modelo abreviado
Un ID de modelo desactualizado
Un modelo que ya no está disponible
Un modelo que no admite el endpoint solicitado
Lea el mensaje de error completo y compare el ID configurado con la página actual de Modelos o la respuesta de /v1/models.
Parámetros de solicitud no admitidos
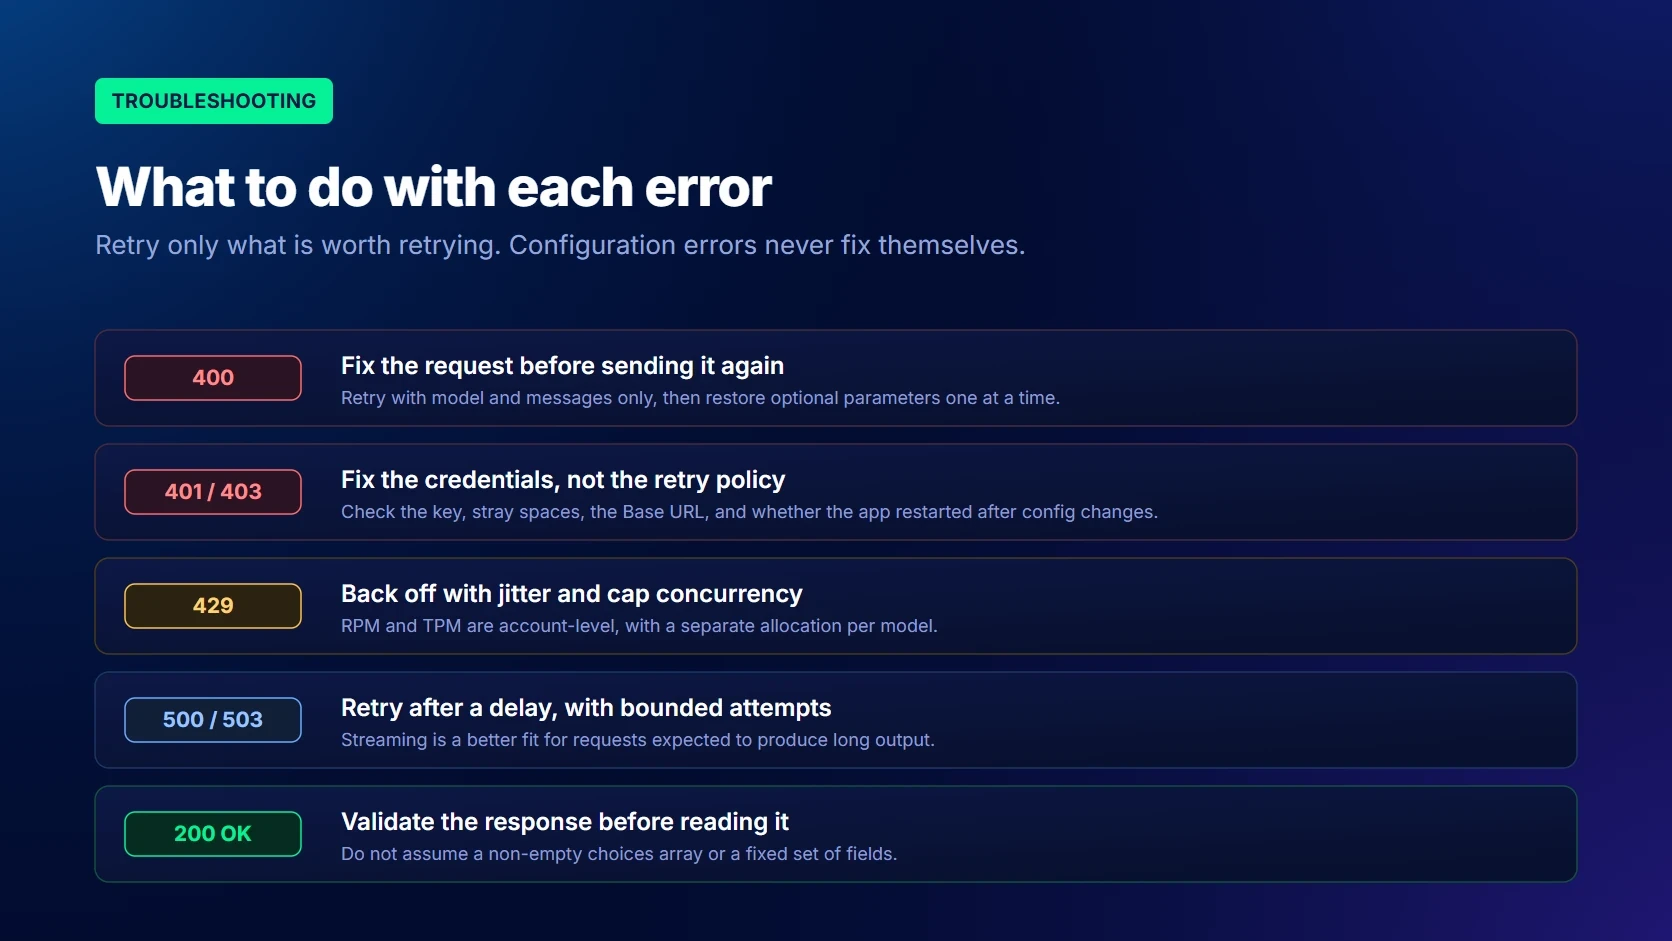
De acuerdo con la guía de gestión de errores de SiliconFlow, una respuesta 400 indica parámetros de solicitud incorrectos. Lea primero el mensaje de error completo, ya que puede identificar un ID de modelo no válido, un campo obligatorio ausente, un parámetro no admitido o un valor con formato incorrecto.
Si la causa sigue sin estar clara, vuelva a intentar la solicitud incluyendo únicamente:
model
messages
Luego restablezca los parámetros opcionales uno por uno. Esto ayuda a identificar si el fallo es causado por las herramientas, la configuración de la salida estructurada, los controles de pensamiento, las entradas de Image o cualquier otro campo no admitido.
Campos de respuesta inesperados
Un modelo puede devolver campos adicionales como reasoning_content. Los analizadores que rechazan todos los campos desconocidos pueden fallar incluso cuando la respuesta sea válida.
Lea únicamente los campos que la aplicación necesita y sea tolerante con las adiciones documentadas en la estructura de la respuesta.
Analizadores de streaming que esperan fragmentos (Chunks) específicos de un proveedor
Un analizador de streaming puede fallar si asume que:
Cada fragmento (chunk) contiene una opción
Cada opción contiene texto
Solo puede aparecer delta.content
El evento final siempre tiene una estructura fija
Valide cada fragmento (chunk) antes de leer los campos anidados y pruebe el analizador con el modelo exacto de producción.
Límites de tarifa (Rate limits) y disponibilidad temporal del modelo
Una respuesta 429 significa que se ha activado un límite de tarifa. SiliconFlow utiliza límites de RPM y TPM para los modelos de lenguaje. Los límites se aplican a nivel de cuenta, mientras que cada modelo tiene una asignación independiente.
Si los límites existentes no satisfacen su carga de trabajo esperada, inicie sesión en SiliconFlow Cloud, seleccione "Higher Limits" en la esquina inferior izquierda y complete la Solicitud de aumento de RPM y TPM de SiliconFlow. Proporcione la información solicitada en función de sus requisitos de uso reales y el tráfico previsto.
Utilice:
Retroceso exponencial (exponential backoff) con aleatoriedad (jitter)
Controles de concurrencia en el lado del cliente
Colas conscientes de los tokens
Reintentos acotados
Un modelo de respaldo (fallback) adecuado
Para respuestas 503 o 504, reintente los fallos temporales tras una breve espera. El streaming también puede ser más apropiado para solicitudes que se espera que generen salidas largas. La guía de errores de la plataforma de SiliconFlow cubre actualmente las respuestas 400, 401, 403, 429, 500 y 503/504.
No reintente fallos de autenticación, parámetros no válidos o IDs de modelo incorrectos sin modificar la configuración.
Lista de control de migración antes de pasar a producción
Verificación
Requisito
Autenticación
Cargue la API Key de forma segura
URL Base
Use https://api.siliconflow.com/v1 para la plataforma global
ID de modelo
Guarde el ID exacto del modelo actual en la configuración
Solicitud básica
Confirme que una solicitud mínima de Chat Completions sea exitosa
Parámetros
Pruebe cada parámetro opcional requerido
Streaming
Gestione fragmentos (chunks) vacíos, interrupciones y campos de razonamiento
Llamada a funciones (Function Calling)
Valide los nombres de las herramientas y sus argumentos antes de la ejecución
Datos estructurados
Analice y valide el JSON y las salidas basadas en esquemas
Vision
Pruebe el formato de la imagen, el acceso, el tamaño y la compatibilidad con el modelo
Razonamiento
Gestione las respuestas finales, los campos de razonamiento y los controles de pensamiento de forma intencionada
Contexto
Pruebe los prompts de producción completos y el historial de conversaciones
Errores
Gestione las respuestas 400, 401, 403, 429, 500, 503 y 504
Reintentos
Reintente solo fallos temporales con un tiempo de espera acotado
Coste
Mida el uso de tokens con solicitudes representativas
Monitorización
Registre el ID del modelo, el estado, la latencia, el ID de solicitud y el uso de tokens
Preguntas frecuentes sobre cómo usar el SDK de OpenAI
P1. ¿Es SiliconFlow totalmente compatible con cada una de las funciones de la API de OpenAI?
No. SiliconFlow admite los patrones habituales del SDK de OpenAI para Chat Completions, pero la cobertura de endpoints, parámetros, campos de respuesta y funciones avanzadas siguen dependiendo del modelo seleccionado.
P2. ¿Qué URL Base de SiliconFlow debo utilizar?
Utilice el siguiente endpoint para la plataforma global:
https://api.siliconflow.com/v1
La API Key debe proceder de la cuenta global de SiliconFlow correspondiente.
P3. ¿Puede una sola aplicación admitir tanto a OpenAI como a SiliconFlow?
Sí. Almacene la API Key, la URL Base y el ID del modelo en la configuración del proveedor o en variables de entorno. De esta forma, la aplicación podrá inicializar el cliente adecuado conservando la lógica principal de sus prompts y mensajes.
Los parámetros específicos del proveedor y las características avanzadas deben probarse por separado.
P4. ¿Por qué funciona un parámetro con un modelo de SiliconFlow pero no con otro?
La API ofrece una capa de solicitud uniforme, pero los modelos subyacentes poseen arquitecturas y capacidades distintas. Las entradas de Vision, las llamadas a herramientas, los controles de razonamiento y los formatos de salida estructurada solo funcionarán con los modelos que admitan dichas características.
P5. ¿Debería cambiar el código de mi aplicación o solo su configuración?
Para una integración básica de Chat Completions, cambiar la API Key, la URL base y el ID del modelo puede ser suficiente.
Es más probable que se requieran cambios en el código si la aplicación depende de un análisis estricto de las respuestas, streaming avanzado, Function Calling, Structured Outputs, entradas de vision, campos de razonamiento o una gestión de errores específica del proveedor.
Conéctese a SiliconFlow sin tener que reescribir su aplicación principal
Conectar una aplicación del SDK de OpenAI a SiliconFlow suele requerir cambios de configuración en lugar de una reescritura completa. Mantenga la API Key, la URL base y el ID del modelo fuera de la aplicación principal, comience con una solicitud mínima de Chat Completions y pruebe cada función avanzada por separado. Este enfoque conserva un flujo de trabajo de desarrollo familiar y, al mismo tiempo, facilita la evaluación de diferentes modelos lingüísticos y multimodales. Antes de pasar a producción, confirme la compatibilidad del modelo actual, los límites de tokens, la gestión de errores, la latencia, el uso y la monitorización mediante solicitudes que reflejen la carga de trabajo real.