Inferencia Serverless frente a GPU reservadas: ¿cuál es mejor para tu carga de trabajo de IA?
Índice de contenidos

A medida que una aplicación de IA pasa de las pruebas a la producción, la infraestructura de inferencia se convierte en una decisión de coste, capacidad y fiabilidad. La inferencia Serverless ofrece flexibilidad cuando la demanda es incierta, mientras que las GPU reservadas pueden proporcionar una capacidad más predecible para cargas de trabajo constantes. Ninguna de las dos opciones es automáticamente mejor. La elección correcta depende de los patrones de tráfico, la utilización de la GPU, los requisitos de latencia, los recursos operativos y el control del despliegue. Con SiliconFlow, los equipos pueden empezar con un acceso a modelos de pago por uso y evaluar la capacidad reservada una vez que dispongan de datos reales sobre la carga de trabajo.
¿Qué es la inferencia Serverless?
La inferencia Serverless permite a los desarrolladores invocar modelos de IA a través de una API sin necesidad de aprovisionar ni mantener la infraestructura de GPU subyacente.
SiliconFlow Serverless Inference gestiona la asignación de recursos y el escalado detrás de la API. Los equipos pagan en función del uso real del modelo en lugar de mantener una capacidad de GPU asignada continuamente. Esto facilita el lanzamiento de una funcionalidad de IA antes de conocer con precisión el volumen de solicitudes y los requisitos de infraestructura.
La inferencia Serverless suele ser una excelente opción para:
Prototipos y validación temprana de productos
Aplicaciones con tráfico variable o intermitente
Equipos que prueban múltiples modelos
Cargas de trabajo estacionales o impulsadas por eventos
Equipos pequeños sin personal dedicado a operaciones de GPU
Serverless no se limita a las demos. Una aplicación en producción puede seguir utilizando la inferencia Serverless cuando el tráfico sigue siendo irregular o cuando los periodos prolongados de inactividad dejarían infrautilizados los recursos reservados.
SiliconFlow también admite el acceso mediante API REST y patrones de llamada compatibles con OpenAI para los modelos admitidos. Esto permite a los desarrolladores utilizar métodos de integración conocidos al tiempo que acceden a los modelos a través de una API unificada.
¿Qué son las GPU reservadas?
Las GPU reservadas proporcionan una capacidad de cómputo dedicada y siempre activa para cargas de trabajo que requieren recursos más predecibles.
Las instancias de GPU reservadas de SiliconFlow permiten a los equipos reservar una cantidad y un modelo específicos de GPU en una región seleccionada. Esto puede reducir la incertidumbre sobre la capacidad para servicios de producción de larga duración y facilitar la previsión del gasto en infraestructura.
Las GPU reservadas son más relevantes para:
Aplicaciones de gran volumen con una demanda sostenida de inferencia
Cargas de trabajo con tráfico base y picos predecibles
Servicios que necesitan una cantidad definida de capacidad de GPU
Modelos personalizados o servicios de inferencia en contenedores
Equipos que requieren configuraciones de GPU específicas
Sistemas de producción con requisitos de capacidad más estrictos
La capacidad reservada sigue requiriendo planificación. Los equipos deben estimar la memoria del modelo, la concurrencia de solicitudes, el rendimiento, la redundancia y el crecimiento esperado. También pueden necesitar configurar imágenes de contenedor, comprobaciones de estado, puertos de servicio, cantidades de instancias, monitorización y actualizaciones de modelos, en función de la disposición del despliegue.
Inferencia Serverless frente a GPU reservadas: diferencias clave
Las búsquedas de «inferencia Serverless frente a GPU dedicada» a menudo se centran en el acceso al hardware, pero las diferencias más importantes radican en la estructura de costes, el escalado, la previsibilidad de los recursos y la responsabilidad operativa.

Dimensión | Inferencia Serverless | GPU reservadas |
|---|---|---|
Facturación | Pago por llamadas al modelo | Coste mensual completo de hardware, recursos no utilizados, tareas de despliegue, monitorización y redundancia |
Escalado | La plataforma gestiona el escalado de la infraestructura | Los equipos planifican la capacidad y ajustan las cantidades de instancias |
Capacidad | No es necesario reservar hardware para cada pico posible | Capacidad de cómputo dedicada y siempre activa |
Operaciones | Sin aprovisionamiento de GPU ni servidores de modelos | Imágenes de contenedor, comprobaciones de estado, registros y versiones de modelos |
Mejor ajuste | Tráfico variable o intermitente | Demanda de inferencia sostenida y predecible |
Modelo de costes
La inferencia Serverless suele ser más económica cuando el uso es irregular. Los equipos pagan por las llamadas al modelo sin asumir el coste de la capacidad de GPU inactiva.
Las GPU reservadas pueden ser más eficientes cuando la demanda es sostenida y el hardware asignado se utiliza de forma productiva. Sin embargo, una factura mensual elevada de API no significa automáticamente que la capacidad reservada vaya a costar menos.
Una comparación útil de costes de inferencia de IA debería tener en cuenta:
Volumen de tokens de Input y Output
Longitud media del contexto y de la respuesta
Selección del modelo
Concurrencia en picos
Tipo y cantidad de GPU
Utilización media de la GPU
Eficiencia del procesamiento por lotes (batching)
Capacidad ociosa
Costes de ingeniería y monitorización
Compare ambas opciones utilizando la misma unidad de negocio. Según la aplicación, esta podría ser el coste por tarea de agente completada, documento procesado, Image generada o interacción con el cliente completada con éxito.
Para la capacidad reservada, incluya el coste mensual íntegro del hardware, los recursos no utilizados, el trabajo de despliegue, la monitorización y la redundancia. Comparar el gasto de la API únicamente con el precio de alquiler de la GPU puede generar un resultado engañoso.
Escalado y planificación de la capacidad
La inferencia Serverless resulta muy útil cuando el tráfico puede aumentar de forma repentina o cuando la demanda futura es difícil de pronosticar. La plataforma se encarga del escalado de la infraestructura, por lo que los equipos no necesitan reservar suficiente hardware para cubrir cada pico posible.
Las GPU reservadas requieren una planificación más minuciosa. Una capacidad insuficiente puede generar colas de solicitudes. Un exceso de capacidad reduce la utilización y aumenta el coste por tarea.
Los contenedores en la nube para GPU de SiliconFlow permiten a los equipos ajustar las cantidades de instancias, actualizar las imágenes de contenedor y cambiar las especificaciones de GPU a medida que evolucionan las necesidades de la carga de trabajo. Esto ofrece control, pero también exige que los equipos comprendan sus requisitos de capacidad.
Consistencia en el rendimiento
Las GPU reservadas proporcionan una base de cómputo más predecible porque la capacidad se asigna a la carga de trabajo. Sin embargo, no garantizan una menor latencia en todas las situaciones.
El rendimiento de la inferencia también depende de:
Arquitectura y tamaño del modelo
Longitud del prompt y del contexto
Longitud de la Output
Memoria de la GPU y capacidad de cómputo
Concurrencia de solicitudes
Software de servicio (serving)
Gestión de colas
Condiciones de red
Los equipos deben monitorizar más allá del tiempo de respuesta promedio. Algunas métricas de producción útiles incluyen:
Tiempo hasta el primer token (Time to First Token)
Tokens por segundo
Latencia p50, p95 y p99
Tiempo en cola
Tasa de errores en solicitudes
Rendimiento (throughput) en picos de concurrencia
Una GPU reservada puede mejorar la previsibilidad de los recursos y, aun así, tener un bajo rendimiento si la configuración del servicio es ineficiente.
Esfuerzo operativo
La inferencia Serverless elimina la necesidad de aprovisionar GPU y operar servidores de modelos. Las aplicaciones en producción todavía requieren monitorización de API, gestión de tiempos de espera (timeouts), reintentos, controles de costes y recuperación de errores.
Los despliegues con GPU reservadas implican una mayor responsabilidad de infraestructura. Según la configuración, es posible que los equipos deban gestionar:
Imágenes de contenedor
Configuraciones de GPU e instancias
Decisiones de escalado
Registros y monitorización
Versiones de modelos
Disponibilidad del servicio
Por tanto, la decisión de infraestructura debe sopesar tanto la capacidad de ingeniería como el coste de cómputo.
¿Cómo saber cuándo pasar de Serverless a capacidad reservada?
No existe un volumen universal de solicitudes, recuento de tokens o umbral de gasto mensual fijo para pasar a GPU reservadas. El punto de equilibrio varía según el modelo, la carga de trabajo, el tipo de GPU y la configuración del servicio.
Busque varias señales en conjunto en lugar de basarse en una sola métrica.
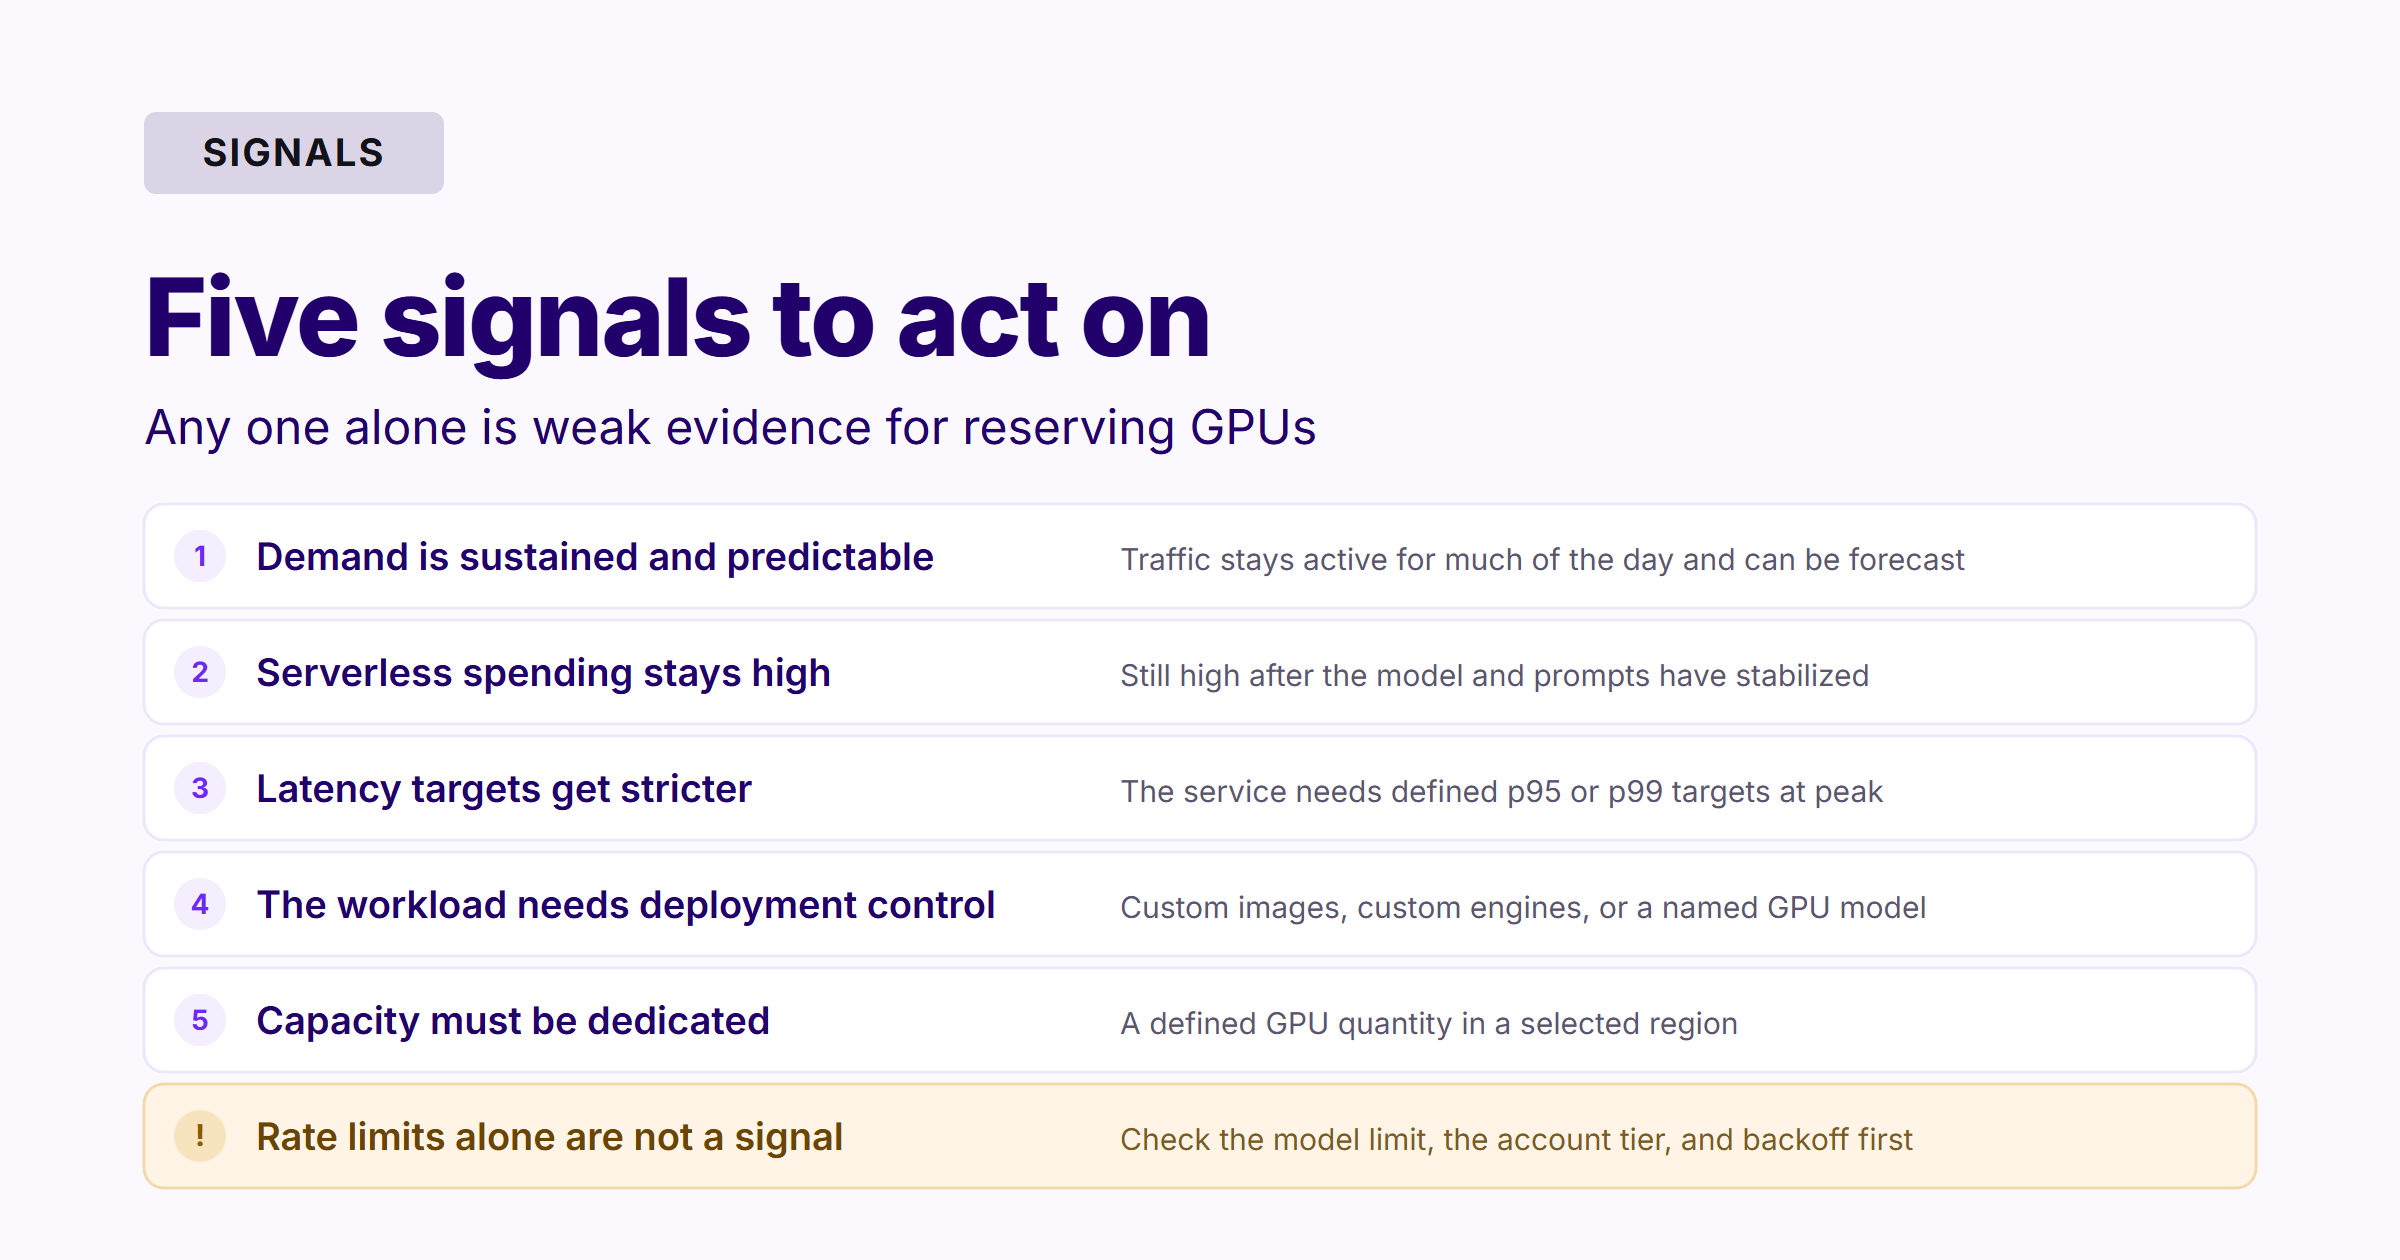
La demanda es sostenida y predecible
El volumen mensual por sí solo no es suficiente. Diez millones de tokens distribuidos uniformemente a lo largo de cada día plantean un requisito de infraestructura diferente al de diez millones de tokens generados durante un único evento breve.
La capacidad reservada resulta más atractiva cuando la demanda de inferencia se mantiene activa durante gran parte del día y el tráfico histórico permite realizar un pronóstico fiable de la capacidad.
El gasto en Serverless sigue siendo alto para una carga de trabajo estable
Analice si el gasto mensual en Serverless se mantiene constantemente alto después de que el modelo, la estructura del prompt y el patrón de tráfico se hayan estabilizado.
A continuación, compare:
Coste Serverless por tarea completada
Utilización prevista de la GPU
Coste total de la capacidad reservada (fully loaded)
Sobrecarga de ingeniería y monitorización
Coste de la capacidad no utilizada
Crecimiento previsto
Merece la pena considerar las GPU reservadas cuando la misma carga de trabajo sostenida puede mantener bien utilizados los recursos asignados. No deben elegirse únicamente porque el gasto total en API haya aumentado con el crecimiento de los usuarios.
Los requisitos de latencia o capacidad se vuelven más estrictos
Un prototipo puede tolerar respuestas lentas ocasionales. Un servicio de producción orientado al cliente puede necesitar objetivos definidos de latencia p95 o p99, así como una capacidad fiable durante periodos de máxima demanda.
Las GPU reservadas pueden ofrecer una base de recursos más controlable. Los equipos aún deben evaluar comparativamente el modelo real, el nivel de concurrencia y la configuración del servicio antes de modificar la infraestructura.
La carga de trabajo necesita mayor control de despliegue
Los recursos reservados pueden ser adecuados cuando un equipo necesita:
Un modelo o cantidad de GPU específicos
Una imagen de contenedor personalizada
Un modelo personalizado o motor de inferencia propio
Un entorno de ejecución controlado
Capacidad de cómputo dedicada
Configuraciones personalizadas de despliegue o escalado
Los contenedores en la nube para GPU de SiliconFlow admiten imágenes configurables, especificaciones de GPU, cantidades de instancias, comprobaciones de estado, puertos y registros.
Los límites de velocidad (Rate Limits) afectan periódicamente a las solicitudes de producción
SiliconFlow aplica límites de velocidad (Rate Limits) a nivel de modelo y de cuenta utilizando métricas como solicitudes por minuto y tokens por minuto. Los límites de los modelos de pago pueden aumentar con los niveles de uso de la cuenta, mientras que algunos modelos utilizan límites fijos.
Las respuestas 429 repetidas no implican automáticamente que una aplicación necesite GPU reservadas. Primero compruebe:
El límite específico del modelo
El nivel actual de la cuenta
El comportamiento de reintentos y esperas (backoff)
El procesamiento por lotes (batching) de solicitudes
El uso de token
La distribución del tráfico
Si existe un nivel de uso superior disponible
La capacidad reservada o a medida pasa a ser relevante cuando la presión de los límites de velocidad (Rate Limits) se combina con una demanda constante y la necesidad de recursos dedicados.
¿Qué debe medir antes de reservar GPU?
Recopile suficientes datos de producción para calcular tanto la capacidad de referencia como la de pico.
Unas cuantas semanas de datos de producción representativos suelen ser más útiles que un benchmark corto realizado en condiciones ideales.
Tres ejemplos prácticos de cargas de trabajo

Una nueva funcionalidad de IA para Chat
Un equipo está probando varios modelos de lenguaje y desconoce cuántos usuarios adoptarán la funcionalidad. El tráfico presenta picos elevados seguidos de largos periodos de inactividad.
Mejor punto de partida: Serverless Inference.
El equipo puede realizar el lanzamiento sin reservar GPU, comparar modelos y recopilar datos reales de uso antes de asumir un compromiso a más largo plazo.
Un asistente de producción estable
Una aplicación utiliza un modelo consolidado a lo largo del día. El volumen de solicitudes, la concurrencia, el uso de tokens y los requisitos de latencia p95 se han vuelto predecibles.
Siguiente paso: evaluar las GPU reservadas.
El equipo puede comparar el coste actual de Serverless por tarea completada con el coste total de la capacidad reservada al nivel de utilización esperado.
Procesamiento nocturno de documentos
Una empresa procesa una gran colección de documentos durante la noche, pero los resultados no se necesitan de forma inmediata.
Considere la Batch API antes de reservar GPU siempre activas.
La Batch API de SiliconFlow funciona de forma independiente de los límites de velocidad (Rate Limits) en línea y está diseñada para tareas en tiempo no real, como evaluación, clasificación, extracción y procesamiento de documentos. Esto puede resultar más adecuado que mantener una capacidad dedicada para una carga de trabajo que solo se ejecuta durante unas horas limitadas.
Cómo elegir la opción de despliegue adecuada en SiliconFlow
La elección entre la inferencia Serverless y las GPU reservadas no tiene por qué ser permanente.
Un camino práctico consiste en comenzar con SiliconFlow Serverless Inference, integrar modelos admitidos a través de una API unificada y evaluar el comportamiento real en producción. Monitorice el coste por tarea, la variabilidad del tráfico, los percentiles de latencia, la presión de los límites de velocidad y el uso del modelo antes de reservar infraestructura.
Cuando la demanda se vuelva sostenida y predecible, las GPU reservadas de SiliconFlow proporcionarán una capacidad dedicada y siempre activa con mayor control sobre los recursos de GPU y el entorno de despliegue. Para cargas de trabajo offline que no sean urgentes, la Batch API ofrece otra alternativa sin consumir los límites de velocidad (Rate Limits) en línea. AI Gateway puede respaldar adicionalmente el acceso unificado, el enrutamiento, la gestión de límites de velocidad y el control de costes a medida que crece el stack de aplicaciones.
Esta flexibilidad permite a los equipos adaptar la infraestructura a la carga de trabajo que tienen en el presente, conservando opciones a medida que evolucionan los requisitos de rendimiento, escala y control.
Preguntas frecuentes (FAQ)
¿Cómo se calcula el punto de equilibrio entre la inferencia Serverless y las GPU reservadas?
Compare el gasto en Serverless y los costes de la capacidad reservada utilizando la misma unidad, como el coste por documento procesado o por tarea de agente completada. Incluya la utilización de la GPU, la capacidad ociosa, el trabajo de ingeniería, la monitorización, la redundancia y el crecimiento esperado, en lugar de contrastar únicamente las tarifas de la API con los precios del hardware.
¿Puede la inferencia Serverless soportar una aplicación LLM en producción?
Sí. La inferencia Serverless puede soportar aplicaciones en producción cuando el tráfico es variable, intermitente o difícil de prever. La decisión debe basarse en el coste, la latencia, la capacidad y los requisitos de límites de velocidad, en lugar de si la aplicación se clasifica como prototipo o como servicio de producción.
¿Qué datos se deben recopilar antes de reservar GPU?
Recopile el volumen de solicitudes y tokens, la concurrencia máxima, la longitud del contexto, la longitud de la Output, el tráfico horario, la latencia p95 y p99, las tasas de fallos, el uso del modelo y el coste por tarea completada. Estas métricas ayudan a estimar los requisitos de capacidad y el tiempo durante el cual el hardware reservado podría permanecer inactivo.
¿Debería la inferencia por lotes offline utilizar GPU reservadas?
No necesariamente. Las cargas de trabajo que no requieren respuestas inmediatas pueden adaptarse mejor a la Batch API. Las GPU reservadas pasan a ser más relevantes cuando el procesamiento por lotes es continuo, exige un entorno personalizado o necesita un cómputo dedicado más allá de las capacidades de un servicio por lotes gestionado.
¿Las GPU reservadas eliminan automáticamente los límites de velocidad (Rate Limits) de la API?
No asuma que cualquier acuerdo de GPU reservadas elimina todos los límites de API. Los límites de velocidad (Rate Limits) de SiliconFlow Serverless se basan en el modelo y en la cuenta, mientras que las instancias dedicadas no suelen utilizar los Rate Limits estándar. Confirme el comportamiento de la opción de despliegue seleccionada antes de dimensionar la capacidad de producción.