DeepSeek V4 Pro en SiliconFlow: niveles de razonamiento, precios y costes para tareas largas
Índice de contenidos
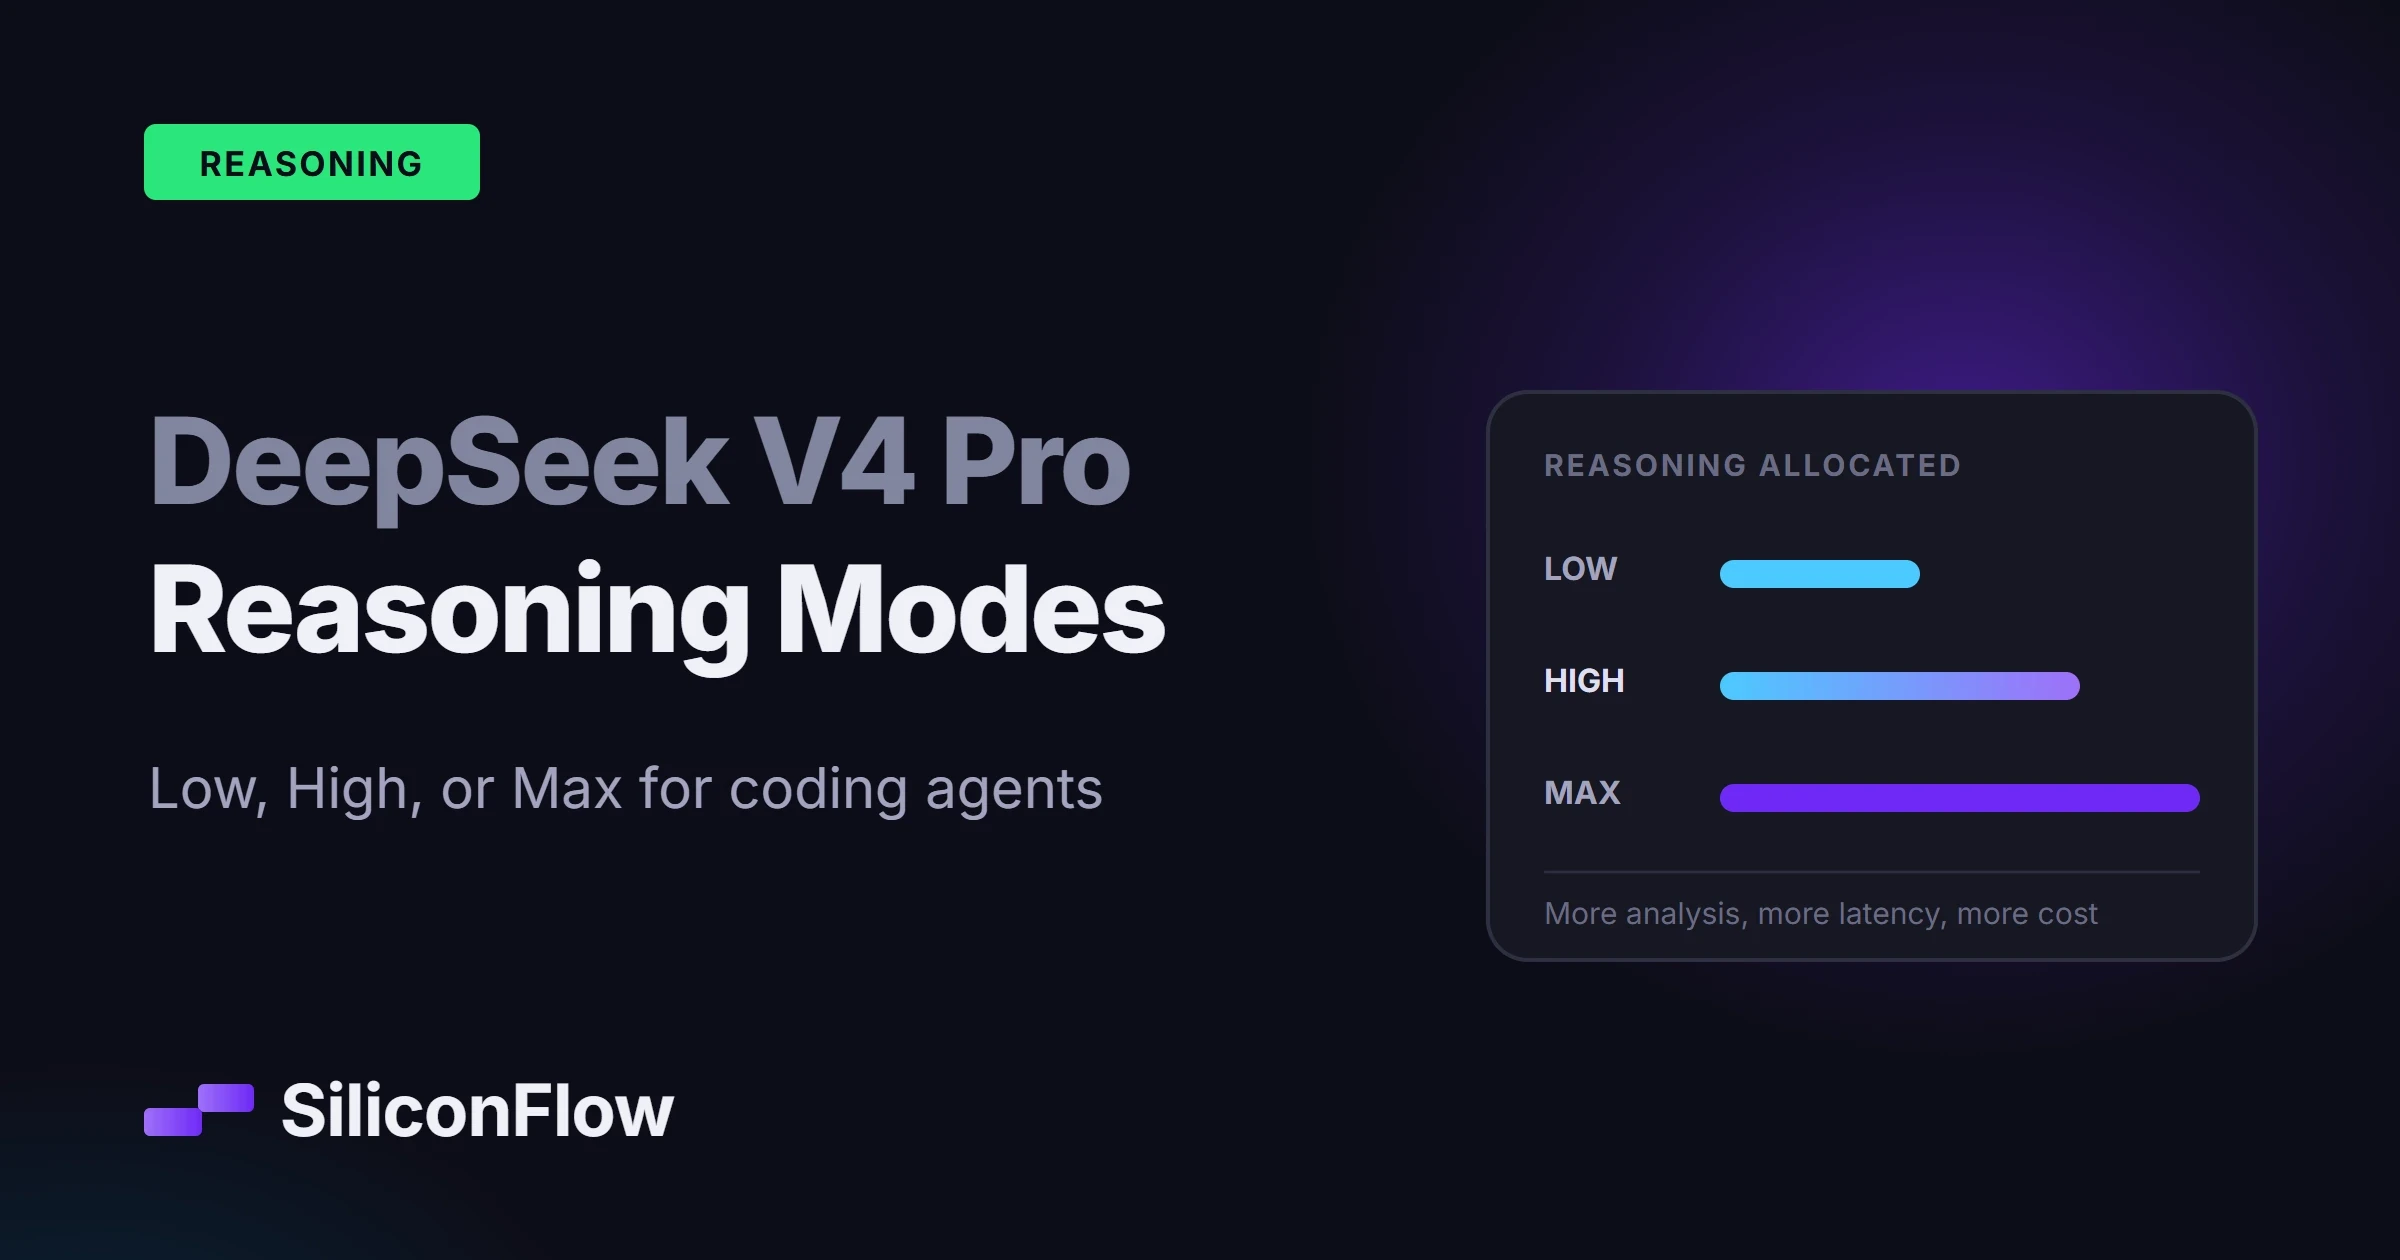
Los modos de razonamiento de DeepSeek V4 Pro ofrecen a un agente de programación tres configuraciones: Low para trabajo rutinario y bien acotado, High para la mayoría de las tareas de desarrollo de varios pasos, y Max para problemas ambiguos o de alto impacto. High es el valor predeterminado práctico, pero una política de enrutamiento sólida también sopesa la dificultad de la tarea, el coste de verificación y el coste de una acción incorrecta. Los equipos deberían medir la calidad de las tareas aceptadas, la latencia y el gasto total de tokens en sus propios repositorios antes de fijar cualquier umbral.
¿Qué cambió en la versión DeepSeek V4 Pro 0813?
Publicada el 13 de agosto de 2026, DeepSeek V4 Pro 0813 sustituyó a la versión preliminar por una versión orientada a producción dirigida a agentes de programación, uso de herramientas y flujos de trabajo más largos. El lanzamiento también introdujo DSpark, el framework de agentes de DeepSeek.
DeepSeek reportó estas mejoras con respecto a la versión preliminar:
Benchmark | V4 Pro Preview | V4 Pro 0813 | Variación |
|---|---|---|---|
Terminal-Bench 2.1 | 72.1 | 87.9 | +15.8 |
DeepSWE | 12.8 | 62.7 | +49.9 |
Toolathlon-Verified | 55.9 | 74.1 | +18.2 |
AutomationBench Public | 12.8 | 31.8 | +19.0 |
Estas son cifras reportadas por el proveedor a partir de la ficha del modelo, no mediciones independientes de SiliconFlow. Las evaluaciones del agente de programación se ejecutaron en el modo minimal de DeepSeek Harness con razonamiento Max, temperatura 1.0 y top_p 0.95. Ese detalle de configuración es importante. La tabla describe el modelo en su configuración de razonamiento más alta, por lo que Low y High pueden producir una calidad, latencia y consumo de tokens diferentes.
La versión 0813 se lanzó bajo el identificador de modelo deepseek-ai/DeepSeek-V4-Pro-0813. Para las solicitudes actuales a la API, utilice deepseek-ai/DeepSeek-V4-Pro a menos que la Model Library de su cuenta indique un ID diferente. Los equipos que necesiten comparaciones reproducibles deben registrar la compilación exacta tras cada ejecución de prueba.
¿Qué controlan los modos de razonamiento Low, High y Max?
Los tres ajustes controlan cuánto trabajo de inferencia puede dedicar el modelo antes de responder o actuar. No modifican los pesos del modelo, no amplían la ventana de contexto, no conceden permisos adicionales de herramientas ni garantizan un resultado correcto.
El nivel de razonamiento tampoco es un límite fijo de output-tokens. Una solicitud en Max no consume el mismo número de tokens cada vez, y una solicitud en Low aún puede devolver una respuesta extensa cuando la tarea lo exige.
Nivel de razonamiento | Comportamiento práctico | Compromiso principal |
|---|---|---|
Low | Prioriza respuestas rápidas para tareas claras y delimitadas | Menor latencia, pero menos tiempo para resolver ambigüedades |
High | Aplica más análisis a flujos de trabajo de agentes y desarrollo de varios pasos | Equilibrio entre calidad, latencia y uso de tokens |
Max | Asigna el máximo esfuerzo de razonamiento a tareas difíciles o inciertas | Mayor capacidad de resolución de problemas con mayor latencia y coste |
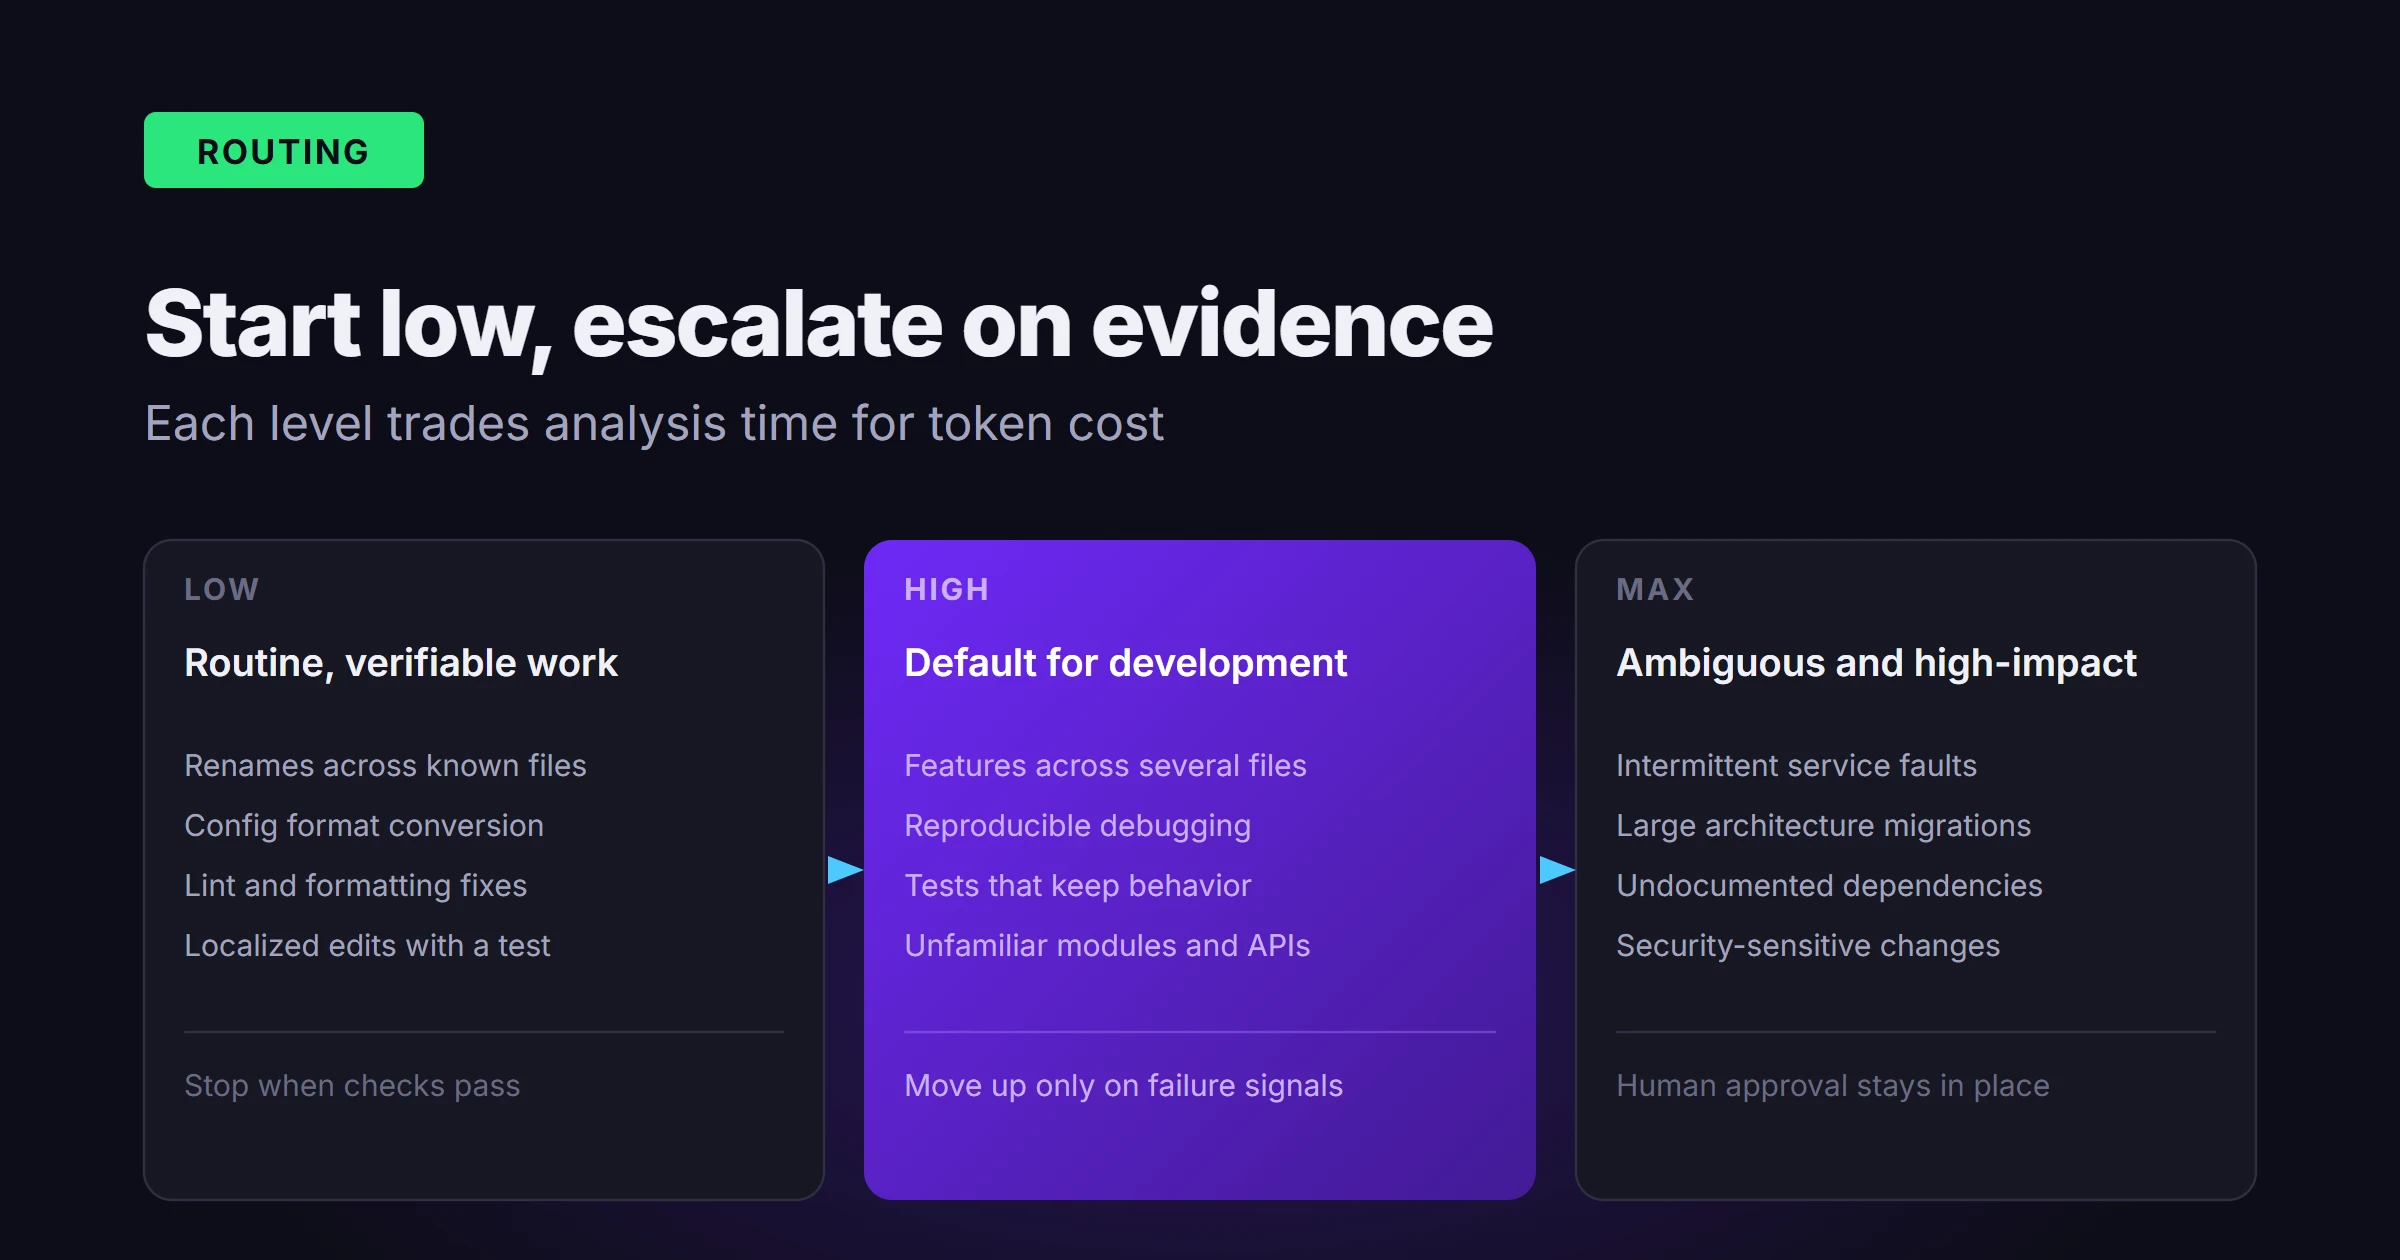
Low suele encajar con prompts que tienen una ruta obvia y un resultado objetivo. High se adapta a tareas en las que el modelo debe inspeccionar varios archivos, invocar herramientas o corregir un primer intento. Max compensa su coste cuando el problema oculta dependencias, se apoya en evidencias incompletas o fallar resulta muy costoso.
Más razonamiento y más contexto resuelven problemas diferentes. Saturar el prompt con contenido irrelevante del repositorio reduce la calidad de la señal, incluso cuando la ventana de contexto puede albergarlo por completo.
¿Cuándo deberían los agentes de programación usar cada nivel de razonamiento?
Una política de enrutamiento viable analiza tres variables: la complejidad de la tarea, la incertidumbre y el coste que supone una acción incorrecta.
Utilice Low para trabajo rutinario y verificable
Low encaja con tareas acotadas cuyo resultado se puede comprobar a bajo coste:
Renombrar un símbolo en archivos conocidos
Convertir formatos de configuración
Generar pruebas repetitivas a partir de un patrón existente
Corregir errores de formateo o de linteo
Explicar una función corta
Clasificar registros o fallos de compilación
Realizar una edición localizada con una prueba de aceptación exacta
El agente aún debe ejecutar el formateador, compilador o comando de prueba pertinente. Low funciona aquí porque la ruta es clara y no se necesita una búsqueda prolongada entre hipótesis rivales.
Pase a un nivel superior desde Low cuando el modelo edite la misma sección repetidamente, falle una prueba determinista, solicite sustancialmente más contexto o no pueda explicar la causa de un error.
Utilice High como valor predeterminado para el trabajo de desarrollo
High es un punto de partida adecuado para flujos de trabajo que encadenan varias decisiones conectadas:
Implementar una característica en múltiples archivos
Depurar un error de aplicación reproducible
Añadir pruebas preservando el comportamiento existente
Trabajar con módulos o API desconocidos
Revisar un parche para comprobar su corrección y mantenibilidad
Utilizar herramientas de búsqueda, shell, pruebas y edición de código en secuencia
Actualizar dependencias con pasos de migración documentados
High suele ofrecer al modelo margen para inspeccionar evidencias, formular un plan, ejecutar herramientas y corregir un intento fallido sin asumir el coste total de Max en cada llamada.
En cargas de trabajo mixtas, dirija primero a High y escale solo cuando aparezcan señales observables de fallo. Esto es más fiable que pedir a los usuarios que adivinen la dificultad antes de que el agente haya leído el repositorio.
Utilice Max para problemas ambiguos o de alto impacto
Reserve Max para tareas donde un análisis más profundo pueda cambiar el resultado:
Diagnosticar fallos intermitentes o entre servicios
Planificar una gran migración arquitectónica
Refactorizar código con dependencias poco claras o no documentadas
Investigar defectos de concurrencia, memoria o de sistemas distribuidos
Resolver fallos tras varios intentos infructuosos
Evaluar cambios críticos para la seguridad
Trabajar a partir de especificaciones incompletas o evidencias contradictorias
Max aumenta las probabilidades de obtener un resultado útil, pero las pruebas y la revisión humana siguen siendo obligatorias. Los cambios de seguridad, las migraciones a producción, las operaciones destructivas en bases de datos y las acciones irreversibles de herramientas deben estar protegidas por límites de permisos explícitos.
Un bucle de escalado práctico sigue este esquema:
Comience en Low para tareas deterministas y en High para desarrollo general.
Valide el resultado con pruebas u otra comprobación objetiva.
Suba un nivel cuando un intento fallido produzca evidencias diagnósticas útiles.
Utilice Max cuando un razonamiento más profundo pueda aprovechar esas evidencias.
Consulte a un humano cuando el obstáculo sea la falta de autorización, requisitos poco claros o sistemas inaccesibles.
Esto evita que un agente gaste más tokens en un problema que un razonamiento adicional no puede resolver.
¿Cómo gestiona DeepSeek V4 Pro las herramientas y las tareas de programación extensas?
DeepSeek V4 Pro admite llamadas a herramientas, una ventana de contexto de aproximadamente 1,049 millones de tokens y hasta 393K output tokens en SiliconFlow. La capacidad utilizable sigue dependiendo de la solicitud combinada, el comportamiento del endpoint y los límites del nivel de cuenta.
Las tareas de programación extensas funcionan mejor cuando el agente mantiene un estado compacto y pertinente:
Recuperar únicamente los archivos vinculados a la hipótesis actual.
Registrar decisiones, intentos fallidos y resultados de pruebas en un breve resumen de trabajo.
Separar la planificación de la ejecución de herramientas.
Volver a inspeccionar los archivos después de que las herramientas los modifiquen.
Ejecutar pruebas focalizadas antes del conjunto completo de pruebas.
Requerir aprobación antes de operaciones destructivas o dirigidas a producción.
Una ventana de contexto amplia reduce la necesidad de un truncamiento agresivo, pero no soluciona la calidad de la recuperación. Los mapas de repositorios, la búsqueda de símbolos, los grafos de dependencias y la selección focalizada de archivos siguen soportando la carga principal.
La compatibilidad con herramientas tampoco significa que el modelo ejecute nada por su cuenta. La aplicación define los esquemas de las herramientas, ejecuta las operaciones solicitadas, devuelve los resultados y aplica los permisos. Un agente para entornos de producción debe limitar las rutas con permisos de escritura, aplicar tiempos de espera (timeouts), validar argumentos y registrar cada acción de las herramientas.
A veces, los modelos emiten argumentos con formato incorrecto o eligen una herramienta inadecuada. Trate las llamadas a herramientas como propuestas estructuradas, valídelas antes de la ejecución y devuelva un mensaje de error procesable cuando la validación falle.

Cómo evaluar DeepSeek V4 Pro en SiliconFlow
Comience con un conjunto de tareas representativo en lugar de un benchmark general. Entre treinta y cien tareas proporcionan una señal temprana cuando reflejan el trabajo que realmente realizará el agente.
El conjunto de evaluación puede incluir pequeñas ediciones deterministas, cambios de características en múltiples archivos, tareas de depuración reproducibles, exploración de repositorios intensiva en herramientas, trabajo con contextos amplios, incidencias ambiguas que requieren aclaración y tareas de alto impacto que exigen aprobación.
Para cada tarea, registre:
Si el parche final supera sus pruebas de aceptación
Si un revisor acepta el parche sin modificaciones importantes
Tokens totales de input, input en caché y output
Latencia de extremo a extremo
Número de llamadas a herramientas
Llamadas a herramientas fallidas o repetidas
Intervención humana requerida
Coste por tarea aceptada
El coste por tarea aceptada aporta más información que el precio por token. Una ejecución económica que no deja de reintentar puede costar más que una ejecución con esfuerzo High completada con éxito.
La siguiente base de referencia utiliza el endpoint de Chat Completions compatible con OpenAI y el ID de modelo actual de la API:
La API directa de DeepSeek expone un parámetro reasoning_effort con los valores low, high y max. No copie ese campo específico del proveedor en una solicitud a SiliconFlow a menos que el endpoint de su cuenta sea compatible con él.
Para los modelos de razonamiento compatibles, la API de Chat Completions de SiliconFlow ofrece en su lugar un parámetro thinking_budget con un valor predeterminado de 4.096 y un rango admitido de 128 a 32.768. La referencia pública de la API no define actualmente reasoning_effort como un campo de solicitud equivalente, por lo que los dos controles no son intercambiables.
Cuando los tres modos de razonamiento se puedan seleccionar en su interfaz o en la configuración de su cuenta, mantenga constantes todas las demás variables de evaluación. Si la superficie de su API no expone estas etiquetas, use su control de razonamiento documentado y evalúe los niveles de presupuesto por separado.
DeepSeek V4 Pro factura los tokens de input no almacenados en caché, input en caché y output con tarifas distintas. El precio actual para el alias deepseek-ai/DeepSeek-V4-Pro, vigente a partir del 26 de agosto de 2026, es:
Tipo de token | Precio por millón de tokens |
|---|---|
Input no almacenado en caché | $1.50162 |
Input en caché | $0.135 |
Output | $3.135 |
Para una solicitud hipotética con 20.000 tokens de input no almacenados en caché, 80.000 tokens de input en caché y 10.000 tokens de output:
Coste de input = 0,02 x $1.50162 = $0.0300324
Coste en caché = 0,08 x $0.135 = $0.0108
Coste de output = 0,01 x $3.135 = $0.03135
Total estimado = $0.0721824, o aproximadamente $0.0722
Tome esa cifra como una ilustración y no como una previsión para una tarea típica de desarrollo. La idoneidad de la caché, el volumen generado, los reintentos y el comportamiento de razonamiento influyen en la cifra real. El almacenamiento en caché de prompts suele alterar mucho más la parte de input de la factura que la de output.
La versión fechada -0813 tiene sus propias tarifas, que pueden diferir de las del alias. Compruebe la página del modelo DeepSeek V4 Pro para el ID exacto que vaya a invocar antes de planificar un presupuesto a su alrededor.

Preguntas frecuentes sobre el razonamiento en DeepSeek V4 Pro
¿Admite DeepSeek V4 Pro el modo JSON Mode en SiliconFlow?
Sí. JSON Mode funciona en SiliconFlow, mientras que los Structured Outputs regulados por esquemas no son compatibles actualmente para este modelo. Las aplicaciones aún deben validar los campos obligatorios, los tipos de datos, los valores permitidos y los casos de error antes de confiar en los datos generados.
¿Se puede autohospedar DeepSeek V4 Pro 0813?
Sí. DeepSeek V4 Pro 0813 se distribuye bajo la Licencia MIT, y la ficha de su modelo incluye directrices de despliegue para frameworks como vLLM y SGLang. Sopese la carga de hardware, memoria, servicio, monitorización y operaciones antes de optar por el autohospedaje frente a la inferencia gestionada.
¿Puede un agente de programación de DeepSeek V4 Pro analizar capturas de pantalla?
No. El modelo admite actualmente input de Text en lugar de input de Image en SiliconFlow. Para tareas de programación basadas en capturas de pantalla, use un modelo de Vision para extraer los detalles relevantes de la interfaz y, a continuación, pase ese Text y el contexto del código a DeepSeek V4 Pro.
¿Debería un agente reintentar una tarea fallida con razonamiento Max?
Solo si el primer intento aportó evidencias diagnósticas útiles. Max no puede subsanar la falta de permisos, la ausencia de dependencias o unos requisitos poco claros. Fije límites de reintentos, conserve el output del error y derive la tarea a un humano cuando el agente carezca de información o autoridad, en lugar de aumentar de nuevo el razonamiento.
Ajuste el esfuerzo de razonamiento a la dificultad de la tarea y al coste total
Los tres modos de razonamiento de DeepSeek V4 Pro equilibran la calidad frente a la latencia y el coste: Low se adapta a tareas acotadas con verificación económica, High es el valor predeterminado práctico para el desarrollo en varios pasos y Max resulta rentable en trabajos ambiguos o de alto impacto.
La política más eficaz es el escalado basado en evidencias: empiece en el nivel más bajo que sea razonable, valide el resultado y aumente el razonamiento solo cuando el fallo revele algo que un análisis más profundo pueda solucionar. Compare los niveles según la tasa de tareas aceptadas, la latencia, los reintentos, el comportamiento de las herramientas y el coste total, en lugar de fijarse únicamente en las puntuaciones de benchmarks o el precio por token.
Mantenga los detalles de despliegue separados de la API directa de DeepSeek. Verifique el ID del modelo activo, utilice los parámetros que admite su endpoint de SiliconFlow, consulte los precios actuales antes de pasar a producción y vuelva a comprobar la página del modelo siempre que cambien los alias, las compilaciones o las tarifas.